










Accélérateurs AMD Instinct

AMD Instinct sur une machine où personne d'autre n'est

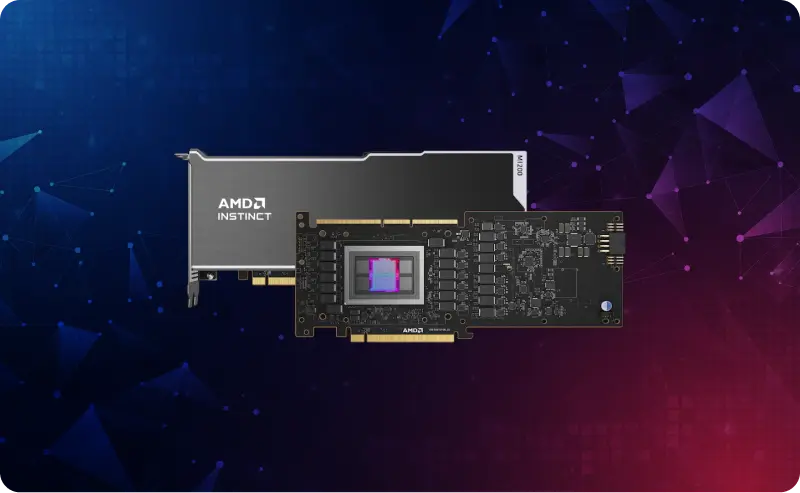
Deux accélérateurs AMD équipent nos serveurs dédiés : l'Instinct MI210 et l'Instinct MI50. La carte est transmise directement à votre propre système d'exploitation — votre build ROCm, votre noyau, vos processus, et aucun hyperviseur entre les deux.

MI210 : 104 unités de calcul CDNA 2, 64 Go HBM2e. MI50 : 60 unités de calcul GCN 5.1, 16 Go. Un seul locataire par machine. Ni découpée, ni partagée dans le temps.

Chaque carte que nous installons — AMD et NVIDIA, actuelles comme depuis longtemps hors production — est répertoriée avec son propre prix mensuel sur le catalogue GPU.

Transformez vos GPU en revenus mensuels passifs

Vous avez des configurations GPU serveur ou de bureau inutilisées ? Mettez-les en ligne dès aujourd'hui sur la marketplace Primcast et percevez des loyers mensuels réguliers de la part d'équipes IA, de développeurs et d'entreprises ayant besoin de calcul de qualité production.

Aller à la Marketplace

Ce qu'est réellement un serveur AMD Instinct ici

Un serveur physique loué à un seul compte, avec un accélérateur AMD dans un slot PCIe et un accès root sur le système d'exploitation au-dessus. La carte est une ligne sur la facture plutôt qu'un niveau de produit, de sorte que la machine sous-jacente ne devient pas plus chère en raison de ce qui y est branché.

La carte est à vous

Pas de partition, pas de vGPU, pas d'ordonnanceur décidant quand votre tour arrive. L'accélérateur est confié directement à votre noyau, vous pouvez donc épingler votre propre version de ROCm et charger vos propres modules sans nous demander.
ROCm, HIP et les frameworks habituels

Les deux composants sont des cibles ROCm prises en charge — gfx90a pour le MI210, gfx906 pour le MI50 — ce sur quoi PyTorch, TensorFlow, JAX et ONNX Runtime s'appuient sur AMD. HIP porte le code source CUDA sans exiger de réécriture.

Tarifé indépendamment de la machine

L'accélérateur a son propre montant mensuel et le serveur en a un autre, et vous additionnez les deux. Changez de carte sans changer de serveur. Les deux montants, pour chaque carte du catalogue, figurent sur la page GPU.

Les deux accélérateurs AMD Instinct que nous installons

Les deux sont commandables aujourd'hui depuis le même configurateur, sur différentes gammes de serveurs. Les chiffres ci-dessous sont ceux publiés par AMD.

Accélérateur AMD Instinct MI210

AMD Instinct MI210

La génération CDNA 2 dans une carte PCIe standard pleine hauteur, pleine longueur, double slot — 104 unités de calcul, 64 Go de HBM2e jusqu'à 1,6 To/s, et jusqu'à trois liaisons Infinity Fabric pour le trafic direct de carte à carte. Refroidie passivement à 300 W sur une liaison hôte PCIe Gen 4. C'est celle qu'il faut demander lorsque toute la question est de savoir si le modèle tient en mémoire.

AMD Instinct MI50

L'ancien composant de génération Vega : silicium GCN 5.1, 60 unités de calcul et 16 Go de mémoire intégrée au boîtier. Plus personne ne loue cette carte, ce qui la rend introuvable ailleurs plutôt que simplement bon marché ici — et elle reste une cible ROCm prise en charge, elle exécute donc le même code HIP et PyTorch que le MI210 pour une fraction du montant mensuel. C'est la manière sensée de faire fonctionner une chaîne d'outils ROCm avant de s'engager sur la grande carte.

Débit matriciel sur le MI210

AMD publie 181,0 TFLOPS de performances matricielles FP16 et BF16 de pointe pour le MI210 à son horloge de pointe de 1 700 MHz, aux côtés de 22,6 TFLOPS de pointe en FP64 et FP32 vectoriel.

La mémoire est la contrainte

64 Go contiennent les poids d'un modèle de 30 milliards de paramètres en 8 bits, ou d'un modèle de 13 milliards en 16 bits, avec de la place restante pour le cache KV. Dimensionner un modèle est une question à part entière, et la page LLM déroule ce calcul à chaque précision.

Ce que l'hôte donne à la carte

La génération de lignes hôte est le fait que presque personne ne publie et celui qui détermine si une carte fonctionne à sa bande passante nominale. Nous publions la nôtre à côté de chaque carte, sur la page GPU.

Rien ne compte les octets

Poids entrants, points de contrôle sortants, jeux de données entrants. Le port n'est pas mesuré, donc un entraînement qui diffuse un corpus n'arrive pas sous forme de facture de bande passante à la fin du mois.

Serveurs dédiés de qualité entreprise HPE propulsés par AMD Instinct™

Entreprise HPE

Votre serveur dédié GPU AMD INSTINCT™ est propulsé par des serveurs HPE Enterprise, garantissant des performances stables pour les charges de travail les plus exigeantes.

Mises à niveau matérielles

Ajoutez facilement des ressources ou des serveurs supplémentaires à votre infrastructure serveur. La plupart des mises à niveau sont traitées sous 24 heures.

Support 24/7

Des experts en serveurs dédiés sont disponibles pour vous assister 24h/24 et 7j/7 via le chat en direct et l'e-mail.

Le MI210 face aux cartes NVIDIA que nous installons aussi

Quatre accélérateurs issus du même catalogue de commande, ce qui compare donc des composants que vous pouvez réellement mettre dans le même panier. Pas de montants mensuels ici volontairement : le catalogue GPU les lit depuis le catalogue de commande au moment de la requête, et un chiffre saisi dans ce tableau peut dériver.

MI210 L40S A100 H100
Architecture GPU CDNA 2 Ada Lovelace NVIDIA Ampere Hopper
Mémoire GPU 64 Go HBM2e 48 Go GDDR6 avec ECC 80 Go HBM2e 80 Go HBM3
Bande passante mémoire GPU Jusqu'à 1,6 To/s 864 Go/s 1 935 Go/s 3 352 Go/s
FP32 22,6 TFLOPS 91,6 TFLOPS 19,5 TFLOPS 51 TFLOPS
Cœur Tensor TF32 366 TFLOPS 312 TFLOPS 756 TFLOPS
Matrice FP16/BF16 181 TFLOPS 733 TFLOPS 624 TFLOPS 1 513 TFLOPS
Puissance Jusqu'à 300 W Jusqu'à 350 W Jusqu'à 400 W Jusqu'à 350 W

Le TF32 est un format de cœur tensoriel NVIDIA. CDNA 2 ne l'implémente pas et AMD ne publie aucun chiffre à son sujet, la colonne MI210 n'affiche donc rien ici plutôt qu'un nombre emprunté à un autre fournisseur. Les lignes de cœurs tensoriels NVIDIA sont les chiffres publiés avec sparsité. Toutes les autres cartes que nous installons, MI50 compris, sont tarifées sur le catalogue GPU.

FAQ sur les serveurs GPU AMD Instinct

Questions courantes sur le déploiement et la gestion des accélérateurs AMD Instinct sur bare metal pour les charges de travail d'IA, de HPC et d'apprentissage automatique.

Quels accélérateurs AMD Instinct puis-je réellement commander ?

Deux : l'Instinct MI210 et l'Instinct MI50. Ce sont les accélérateurs AMD de notre catalogue de commande, et le configurateur ne vous proposera rien d'autre de la gamme Instinct. Le MI210 est disponible sur trois de nos gammes de serveurs et le MI50 sur deux. Nous n'installons pas le MI250, le MI250X ni le MI300A, et ne l'avons jamais fait.

Quelle est la différence entre le MI210 et le MI50 ?

La génération et la mémoire. Le MI210 est l'architecture CDNA 2 d'AMD avec 104 unités de calcul et 64 Go de HBM2e jusqu'à 1,6 To/s, dans une carte PCIe double slot consommant jusqu'à 300 W sur une liaison hôte PCIe Gen 4, avec jusqu'à trois liaisons Infinity Fabric pour le trafic de carte à carte. Le MI50 est la génération GCN 5.1 antérieure avec 60 unités de calcul et 16 Go. Les deux sont des cibles ROCm prises en charge, le même code HIP et PyTorch s'exécute donc sur l'un comme sur l'autre — le MI210 contient simplement quatre fois plus d'un modèle.

De combien de mémoire carte le modèle que je veux exécuter a-t-il besoin ?

Les poids seuls sont les paramètres multipliés par les octets par paramètre : environ 16 Go pour un modèle de 7 à 8 milliards de paramètres en 16 bits, 28 Go pour 13 à 14 milliards, 68 Go pour 30 à 34 milliards. Le cache KV et l'environnement d'exécution s'ajoutent par-dessus, c'est pourquoi une carte de 16 Go ne sert pas confortablement un modèle dont les poids font 16 Go. Les 64 Go du MI210 couvrent un modèle de 30 milliards quantifié en 8 bits avec de la marge pour travailler. La page de dimensionnement LLM contient le tableau complet — la mémoire nécessaire pour chaque taille de modèle, et quelle carte la satisfait.

Combien de temps faut-il pour déployer un serveur GPU AMD Instinct ?

Lorsque la machine est déjà en rack, elle est généralement activée environ 30 minutes après l'encaissement du paiement. Dans le cas contraire, elle est construite à la commande et le délai dépend des composants. Demandez avant de payer si la date compte — les serveurs instantanés est la page qui montre ce qui est en rack en ce moment même. Chaque serveur inclut la réinstallation instantanée du système d'exploitation, vous pouvez donc itérer sans rouvrir de ticket.

Quels logiciels et frameworks fonctionnent sur ces cartes ?

ROCm, la plateforme de calcul GPU open source d'AMD. Les deux composants sont des cibles ROCm prises en charge — gfx90a sur le MI210, gfx906 sur le MI50 — ce qui couvre PyTorch, TensorFlow, JAX et ONNX Runtime, ainsi que les bibliothèques primitives BLAS, FFT, RNG et d'apprentissage profond. HIP porte le code source CUDA existant sans exiger de réécriture. Comme vous disposez d'un accès root sur bare metal, vous choisissez vous-même les versions de ROCm et du noyau, et pouvez exécuter l'ensemble dans Docker ou sous Kubernetes.