
La détection d’objets, la classification et la segmentation sont ce pour quoi ces composants ont été conçus. Les réseaux sont petits et quantifiés en int8 — la classe MobileNet et EfficientDet, compilés pour le module à l’avance — et ils répondent en quelques millisecondes sur la machine qui détient les images.
Les deux modules consomment quelques watts, si bien qu’un flux de caméra ou un flux de capteurs peut être analysé en continu sans occuper le processeur hôte. Les cœurs restent libres pour votre application ; le module fait les calculs.
Un modèle qui se mesure en milliards de paramètres ne tient sur aucun des deux modules, quelle que soit la quantification, et cette page ne prétendra pas le contraire. Dimensionner un modèle de langage est un calcul à part entière, expliqué sur ce qu’il faut pour exécuter un modèle ; les cartes discrètes qui en exécutent un, chacune tarifée à côté de sa machine, sont sur serveurs dédiés GPU.
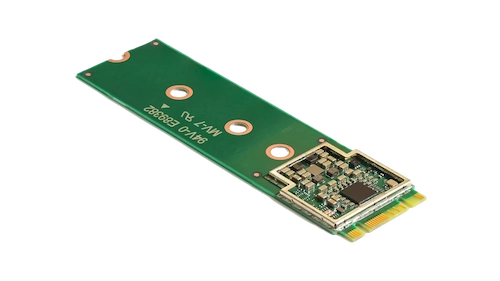
Le module Coral de Google embarque l’Edge TPU, que Google évalue à 4 billions d’opérations par seconde sur entiers 8 bits pour environ deux watts. Ce sont les chiffres du fabricant, cités tels que publiés — pas une mesure de notre part.
Il exécute des modèles TensorFlow Lite qui ont été quantifiés en int8 et compilés pour l’Edge TPU à l’avance. Cette étape de compilation est le coût honnête du composant : un modèle se compile pour lui ou non, et les réseaux edge classiques — classification, détection, pose — sont ceux qui le font.
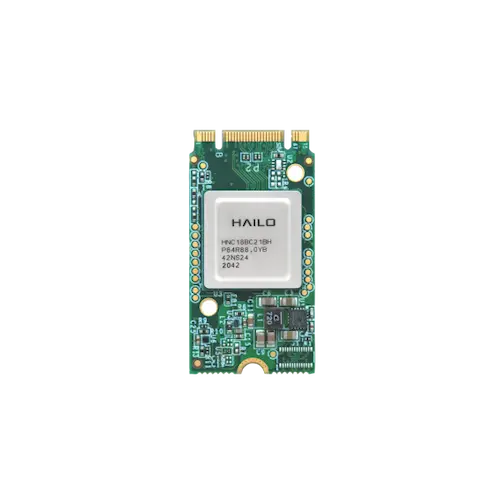
Hailo évalue le Hailo-8 jusqu’à 26 téra-opérations par seconde sur entiers 8 bits — là encore le chiffre du fabricant, cité tel que publié. C’est le plus grand des deux modules, et de loin, et celui qu’il faut demander quand un réseau de la taille du Coral ne suffit pas.
Les modèles lui parviennent depuis TensorFlow ou ONNX via le compilateur propre à Hailo, et son runtime les sert sur votre machine. Comme pour le Coral, l’étape de compilation décide de ce qui s’exécute : c’est un composant pour réseaux de neurones, pas du calcul généraliste.

Le module n’est pas un niveau de produit : c’est une ligne du configurateur de la cartouche, ajoutée au montant propre de la machine. Aucun des deux chiffres n’est saisi ici, car un prix appartient à côté de la machine avec laquelle il vient — la même règle que suit chaque page de cette famille.
Le slot M.2 équipe une cartouche HPE Moonshot. Configurez la m710x (Xeon E3-1585L v5 quadricœur) ou la m510 (Xeon D, huit ou seize cœurs) et ajoutez le module en option.
La machine est à vous seul, avec accès root. Le runtime du fabricant — TensorFlow Lite avec la bibliothèque Edge TPU pour le Coral, HailoRT de Hailo pour le Hailo-8 — s’installe sur votre système d’exploitation et reste à la version que vous épinglez. Rien ne se met à jour sous vos pieds.
L’étape supérieure n’est pas un module plus grand ; c’est une carte discrète dans une machine conçue pour en accueillir une. Serveurs dédiés GPU présente chaque carte que nous installons, tarifée à côté de sa machine ; multi-GPU et multi-nœuds en propose plus d’une.










