La tarjeta es tuya
Sin particiones, sin vGPU, sin un planificador que decida cuándo te toca. El acelerador se entrega directamente a tu kernel, así que fijas tu propia versión de ROCm y cargas tus propios módulos sin pedírnoslo a nosotros.
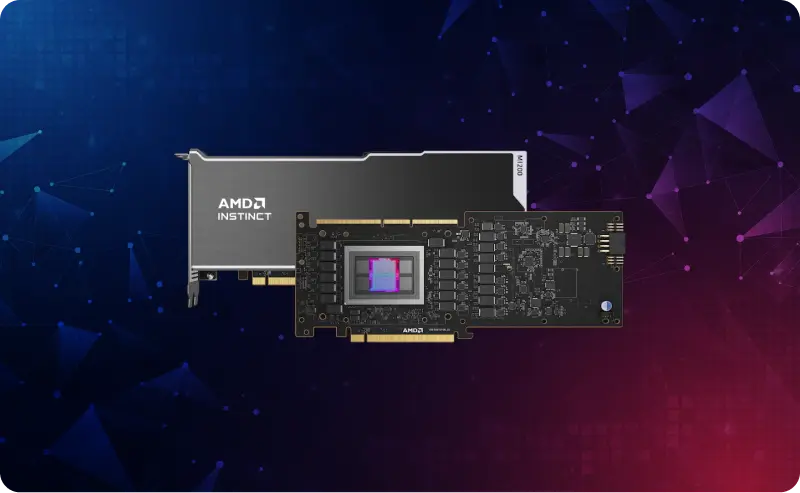
Dos aceleradores AMD van en nuestros servidores dedicados: el Instinct MI210 y el Instinct MI50. La tarjeta se pasa directamente a tu propio sistema operativo — tu compilación de ROCm, tu kernel, tus procesos, y ningún hipervisor de por medio.
Los propietarios anuncian sus máquinas AMD Instinct en nuestro marketplace y fijan su propio precio mensual. Una tarjeta que indica que se anuncia a través de nuestra empresa hermana, Server Room, se alquila en serverroom.net y no aquí.
Un servidor físico alquilado a una sola cuenta, con un acelerador AMD en una ranura PCIe y acceso root al sistema operativo que corre encima. La tarjeta es una línea en la factura y no un nivel de producto, de modo que la máquina subyacente no se encarece por lo que tenga enchufado.
Ambos se pueden pedir hoy desde el mismo configurador, en líneas de servidor distintas. Las cifras de abajo son las publicadas por la propia AMD.
Cuatro aceleradores del mismo catálogo de pedidos, así que esto compara piezas que realmente puedes poner en la misma cesta. Sin cifras mensuales aquí a propósito: el catálogo de GPU las lee del catálogo de pedidos en el momento de la solicitud, y una cifra escrita en esta tabla puede quedar desactualizada.
| MI210 | L40S | A100 | H100 | |
|---|---|---|---|---|
| Arquitectura de GPU | CDNA 2 | Ada Lovelace | NVIDIA Ampere | Hopper |
| Memoria de GPU | 64 GB HBM2e | 48 GB GDDR6 con ECC | 80 GB HBM2e | 80 GB HBM2e |
| Ancho de banda de memoria de GPU | Hasta 1,6 TB/s | 864 GB/s | 1935 GB/s | 2039 GB/s |
| FP32 | 22,6 TFLOPS | 91,6 TFLOPS | 19,5 TFLOPS | 51 TFLOPS |
| Núcleo Tensor TF32 | — | 366 TFLOPS | 312 TFLOPS | 756 TFLOPS |
| Matriz FP16/BF16 | 181 TFLOPS | 733 TFLOPS | 624 TFLOPS | 1513 TFLOPS |
| Potencia | Hasta 300 W | Hasta 350 W | Hasta 300 W | Hasta 350 W |
Preguntas habituales sobre el despliegue y la gestión de aceleradores AMD Instinct en bare metal para cargas de trabajo de IA, HPC y aprendizaje automático.