
La detección de objetos, la clasificación y la segmentación son para lo que se construyeron estas piezas. Las redes son pequeñas y están cuantizadas en int8 — de la clase MobileNet y EfficientDet, compiladas para el módulo con antelación — y responden en milisegundos en la máquina que guarda los fotogramas.
Ambos módulos consumen vatios de un solo dígito, de modo que una señal de cámara o un flujo de sensores puede evaluarse durante todo el día sin ocupar el procesador anfitrión. Los núcleos quedan libres para su aplicación; el módulo hace la aritmética.
Un modelo medido en miles de millones de parámetros no cabe en ninguno de los dos módulos, en ninguna cuantización, y esta página no fingirá lo contrario. Dimensionar un modelo de lenguaje es su propia aritmética y vive en lo que se necesita para ejecutar un modelo; las tarjetas discretas que sí ejecutan uno, cada una con su precio junto a su máquina, están en servidores dedicados con GPU.
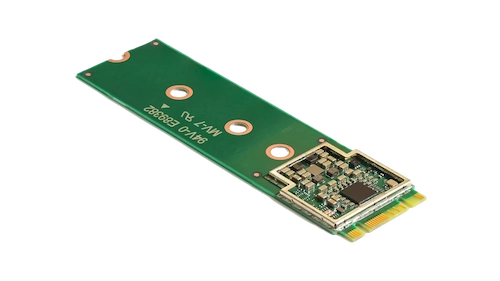
El módulo Coral de Google lleva el Edge TPU, que Google califica en 4 billones de operaciones por segundo con enteros de 8 bits a unos dos vatios. Son las cifras del fabricante, citadas tal como se publicaron — no una medición nuestra.
Ejecuta modelos de TensorFlow Lite que se han cuantizado a int8 y compilado para el Edge TPU con antelación. Ese paso de compilación es el coste honesto de la pieza: un modelo o compila para ella o no lo hace, y las redes de borde clásicas — clasificación, detección, pose — son las que sí lo hacen.
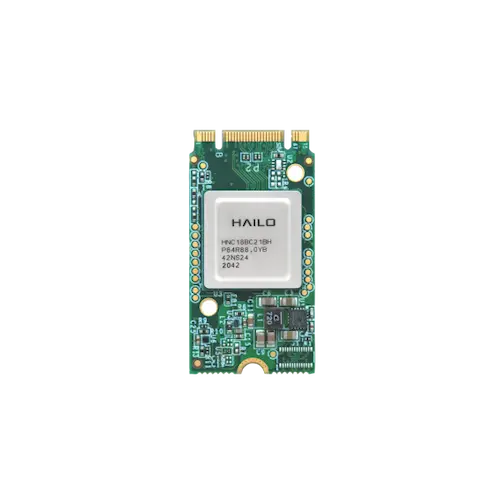
Hailo califica el Hailo-8 en hasta 26 teraoperaciones por segundo con enteros de 8 bits — de nuevo la cifra del fabricante, citada tal como se publicó. Es el mayor de los dos módulos con diferencia, y el que hay que pedir cuando una red del tamaño de Coral no basta.
Los modelos le llegan desde TensorFlow u ONNX a través del compilador propio de Hailo, y su tiempo de ejecución los sirve en su máquina. Como con el Coral, el paso de compilación decide qué se ejecuta: esta es una pieza de red neuronal, no de cómputo de propósito general.

El módulo no es una categoría de producto: es una línea en el configurador del cartucho, añadida a la cifra propia de la máquina. Ninguno de los dos números se escribe aquí, porque un precio pertenece junto a la máquina con la que viene — la misma regla que sigue cada página de esta familia.
La ranura M.2 va en un cartucho HPE Moonshot. Configure el m710x (Xeon E3-1585L v5 de cuatro núcleos) o el m510 (Xeon D, ocho o dieciséis núcleos) y añada el módulo como opción.
La máquina es solo suya, con root. El tiempo de ejecución del fabricante — TensorFlow Lite con la biblioteca Edge TPU para el Coral, HailoRT de Hailo para el Hailo-8 — se instala en su sistema operativo y se queda en la versión que usted fije. Nada se actualiza debajo de usted.
El paso siguiente no es un módulo más grande; es una tarjeta discreta en una máquina construida para aceptarla. Servidores dedicados con GPU es cada tarjeta que instalamos, con su precio junto a su máquina; multi-GPU y multinodo es más de una.










