AMD Instinct 加速器

AMD Instinct 搭载在无人能及的机器上

我们的专用服务器配备两款 AMD 加速器:Instinct MI210 和 Instinct MI50。显卡直通到您自己的操作系统 — 您的 ROCm 构建、您的内核、您的进程,中间没有任何虚拟机监控程序。

MI210:104 个 CDNA 2 计算单元,64 GB HBM2e。 MI50:60 个 GCN 5.1 计算单元,16 GB。 每台机器一位租户。不切片,不分时共享。

我们安装的每一张显卡 — AMD 和 NVIDIA,无论是当前在产还是早已停产的 — 都在 GPU 目录上列出了各自的月租价格。

将您的 GPU 变成每月被动收入

有闲置的服务器或台式机 GPU 配置吗?立即在 Primcast 市场上架,从需要生产级算力的 AI 团队、开发者和企业那里赚取稳定的月租收入。

前往市场

这里的 AMD Instinct 服务器究竟是什么

一台租给单个账户的物理服务器,PCIe 插槽中装有 AMD 加速器,并在其上的操作系统拥有 root 权限。显卡是发票上的一项,而不是产品层级,因此底层机器不会因为插了什么卡而变得更贵。

显卡完全属于您

没有分区,没有 vGPU,没有调度程序来决定何时轮到您。加速器直接交给您的内核,因此您可以自行固定 ROCm 版本并加载自己的模块,无需向我们申请。

ROCm、HIP 及常用框架

这两款部件都是受支持的 ROCm 目标 — MI210 对应 gfx90a,MI50 对应 gfx906 — 这正是 PyTorch、TensorFlow、JAX 和 ONNX Runtime 在 AMD 上构建所依据的。HIP 将 CUDA 源代码移植过来,而无需重写。

与机器分开定价

加速器有自己的月度价格,服务器也有另一个价格,两者相加即可。无需更换服务器即可更换显卡。目录中每张卡的两个价格都列在 GPU 页面上。

我们安装的两款 AMD Instinct 加速器

两款今天都可以从同一个配置器订购,适用于不同的服务器系列。以下数据为 AMD 官方公布的数据。
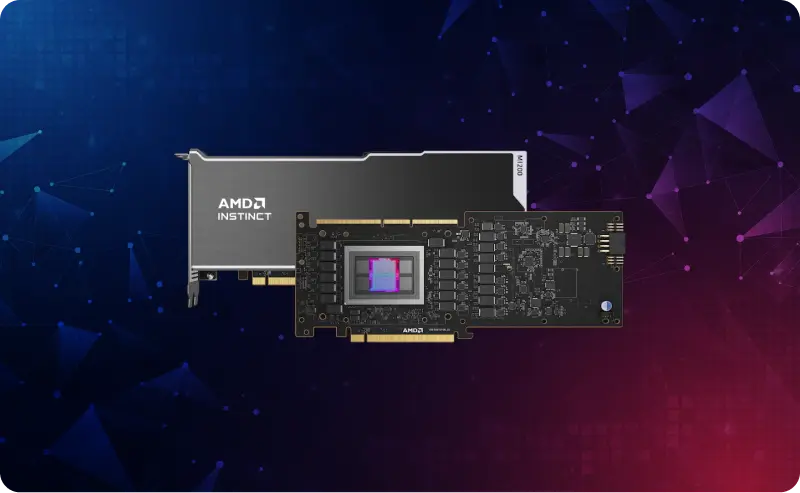
AMD Instinct MI210 加速器

AMD Instinct MI210

CDNA 2 代产品,采用标准全高、全长、双槽 PCIe 显卡 — 104 个计算单元,64 GB HBM2e,带宽高达 1.6 TB/s,并配备最多三条 Infinity Fabric 链路用于卡间直连通信。通过 PCIe Gen 4 主机链路以 300 W 被动散热。当问题的核心是模型能否装入内存时,这就是您该选择的那一款。

AMD Instinct MI50

较旧的 Vega 代产品:GCN 5.1 芯片,60 个计算单元和 16 GB 封装内存。如今已无人出租这张卡,这使得它在别处难以获得,而在这里却不仅仅是便宜 — 而且它仍然是受支持的 ROCm 目标,因此可以运行与 MI210 相同的 HIP 和 PyTorch 代码,而月费仅为后者的一小部分。在投入大卡之前,这是让 ROCm 工具链跑起来的明智之选。

MI210 的矩阵吞吐量

AMD 公布 MI210 在其 1,700 MHz 峰值加速引擎时钟下的峰值 FP16 和 BF16 矩阵性能为 181.0 TFLOPS,同时峰值 FP64 和 FP32 向量性能为 22.6 TFLOPS。

内存是制约因素

64 GB 可以容纳一个 300 亿参数模型在 8 位精度下的权重,或者一个 130 亿参数模型在 16 位精度下的权重,并为 KV 缓存留出空间。模型规模本身就是一个问题,LLM 页面针对每种精度都做了详细计算。

主机为显卡提供什么

主机通道代际几乎是无人公布的事实,而它决定了显卡能否以其设计带宽运行。我们将我们的数据公布在每张卡旁边,就在 GPU 页面上。

没有任何东西计算字节数

权重传入,检查点传出,数据集传入。端口不限流量,因此流式传输语料库的训练运行不会在月底变成一张带宽账单。

适用于 AMD Instinct™ 显卡的企业级专用服务器

HPE、Dell 或 Supermicro

您的 AMD Instinct™ 显卡将安装到 HPE、Dell 或 Supermicro 服务器中,具体取决于您订购的服务器系列。MI210 也可以装入按需定制的 AMD EPYC 服务器,而 AMD 独立服务器 会按核心数为这些处理器定价。

硬件升级

轻松为您的服务器基础设施添加资源或额外服务器。大多数升级在 24 小时内处理完毕。

24/7 支持

专用服务器专家通过在线聊天和电子邮件全天候提供协助。

MI210 与我们同样安装的 NVIDIA 显卡对比

同一订单目录中的四款加速器,因此这里比较的是您实际上可以放入同一购物车的部件。此处特意不列月度价格:GPU 目录会在请求时从订单目录中读取价格,而手动输入到表格中的价格可能会过时。

MI210 L40S A100 H100
GPU 架构 CDNA 2 Ada Lovelace NVIDIA Ampere Hopper
GPU 内存 64GB HBM2e 48GB GDDR6(带 ECC) 80GB HBM2e 80GB HBM2e
GPU 内存带宽 最高 1.6 TB/s 864 GB/s 1935 GB/s 2039 GB/s
FP32 22.6 TFLOPS 91.6 TFLOPS 19.5 TFLOPS 51 TFLOPS
TF32 Tensor Core — 366 TFLOPS 312 TFLOPS 756 TFLOPS
FP16/BF16 矩阵 181 TFLOPS 733 TFLOPS 624 TFLOPS 1513 TFLOPS
功耗 最高 300W 最高 350W 最高 300W 最高 350W

TF32 是 NVIDIA 的张量核心格式。CDNA 2 不实现该格式,AMD 也未公布相关数据,因此 MI210 列在此处显示为空,而不是借用其他厂商的数字。NVIDIA 张量核心行是包含稀疏性的公布数据。我们安装的其他所有显卡,包括 MI50,都在 GPU 目录上标有价格。

关于 AMD Instinct GPU 服务器的常见问题

关于在裸机上为 AI、HPC 和机器学习工作负载部署和管理 AMD Instinct 加速器的常见问题。

我实际上可以订购哪些 AMD Instinct 加速器?

两款:Instinct MI210 和 Instinct MI50。这些是我们订单目录中的 AMD 加速器,配置器不会向您提供 Instinct 系列的其他任何产品。MI210 适用于我们的三个服务器系列,MI50 适用于两个。我们不安装 MI250、MI250X 或 MI300A,而且从未安装过。

MI210 和 MI50 有什么区别?

代际和内存。MI210 采用 AMD 的 CDNA 2 架构,拥有 104 个计算单元和 64 GB HBM2e,带宽高达 1.6 TB/s,采用双槽 PCIe 显卡,通过 PCIe Gen 4 主机链路功耗最高 300 W,并配备最多三条 Infinity Fabric 链路用于卡间通信。MI50 是较早的 GCN 5.1 代产品,拥有 60 个计算单元和 16 GB 内存。两者都是受支持的 ROCm 目标,因此相同的 HIP 和 PyTorch 代码可以在任一卡上运行 — MI210 只是能容纳四倍大的模型。

我想运行的模型需要多少显卡内存?

仅权重就是参数量乘以每个参数的字节数:16 位精度下,70-80 亿参数模型约需 16 GB,130-140 亿参数模型约需 28 GB,300-340 亿参数模型约需 68 GB。KV 缓存和运行时还要在此基础上增加,这就是为什么 16 GB 的显卡无法舒适地服务权重为 16 GB 的模型。MI210 的 64 GB 可以容纳一个量化到 8 位的 300 亿参数模型,并留有工作空间。LLM 规模页面有完整的表格 — 每种模型规模需要多少内存,以及哪张卡能满足需求。

部署 AMD Instinct GPU 服务器需要多长时间?

如果机器已经上架,通常在付款到账后约 30 分钟即可激活。如果尚未上架,则按订单组装,交付时间取决于部件。如果日期很重要,请在付款前询问 — 即时服务器页面列出了当前已在机架上的机器。每台服务器都包含即时操作系统重装,因此您可以反复尝试而无需重新提交工单。

这些显卡上可以运行哪些软件和框架?

ROCm,AMD 的开源 GPU 计算平台。这两款部件都是受支持的 ROCm 目标 — MI210 上为 gfx90a,MI50 上为 gfx906 — 涵盖 PyTorch、TensorFlow、JAX 和 ONNX Runtime,以及 BLAS、FFT、RNG 和深度学习基础库。HIP 将现有 CUDA 源代码移植过来,而无需重写。由于您在裸机上拥有 root 权限,您可以自行选择 ROCm 和内核版本,并可以在 Docker 中或 Kubernetes 下运行整个环境。