
目标检测、分类和分割正是这些部件被制造出来的目的。网络规模小且经过 int8 量化 — 属于 MobileNet 和 EfficientDet 一类,提前为模块编译好 — 它们在保存帧的机器上以毫秒级响应。
两个模块的功耗都只有个位数瓦特,因此摄像头画面或传感器数据流可以全天候评分,而无需占用主机处理器。核心保持空闲供您的应用使用;模块负责运算。
参数以十亿计的模型在任何量化精度下都无法装入这两个模块,本页面也不会假装可以。为语言模型确定规模是另一套运算,见 运行一个模型需要什么;真正能运行语言模型的独立显卡,每张都标价在其机器旁,见 GPU 专用服务器。
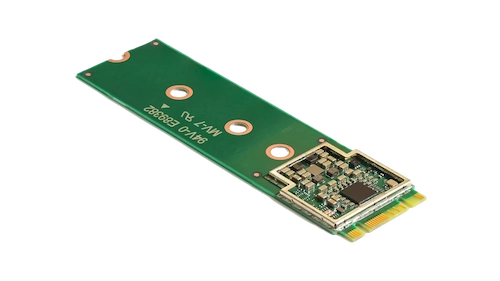
Google’s Coral 模块搭载 Edge TPU,Google 标称其在约两瓦功耗下每秒可执行 4 万亿次 8 位整数运算。这些是厂商公布的数据,按原样引用 — 并非我们的测量结果。
它运行已量化为 int8 并提前为 Edge TPU 编译好的 TensorFlow Lite 模型。这个编译步骤是该部件的真实成本:模型要么能为其编译,要么不能,而经典的边缘网络 — 分类、检测、姿态 — 正是能够编译的那些。
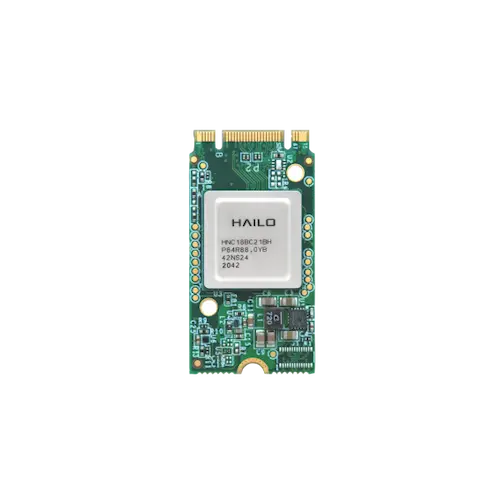
Hailo 标称 Hailo-8 在 8 位整数运算上最高可达每秒 26 万亿次运算 — 同样是厂商公布的数据,按原样引用。它是两个模块中明显更大的一个,当 Coral 规模的网络不够用时,应该选择它。
模型通过 Hailo 自有的编译器从 TensorFlow 或 ONNX 导入,其运行时在您的机器上为它们提供服务。与 Coral 一样,编译步骤决定什么能运行:这是一个神经网络部件,而非通用计算。

该模块不是一个产品层级:它是机箱配置器上的一行,加到机器自身的价格之上。两个数字都不会在这里列出,因为价格应标注在它所搭配的机器旁 — 本系列每个页面都遵循同样的规则。
这台机器完全属于您,拥有 root 权限。厂商的运行时 — Coral 使用带 Edge TPU 库的 TensorFlow Lite,Hailo-8 使用 Hailo 的 HailoRT — 安装在您的操作系统上,并保持在您固定的版本。不会有任何东西在您不知情的情况下升级。










