Akceleratory AMD Instinct

AMD Instinct na maszynie, na której nie ma nikogo innego

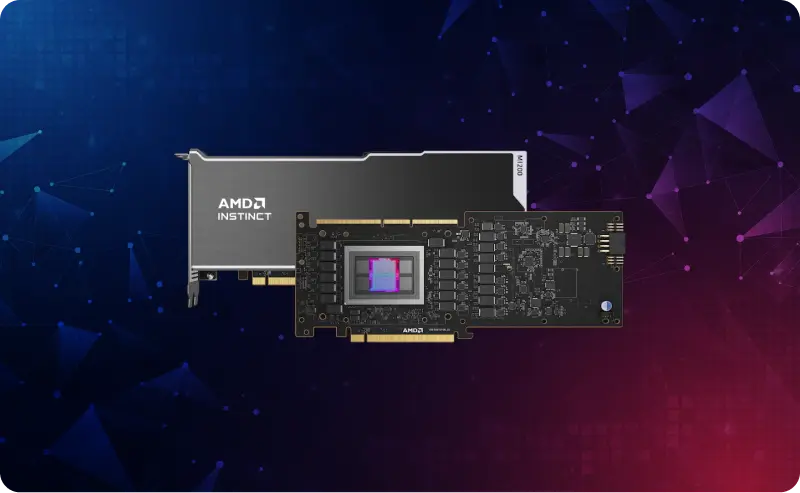
Do naszych serwerów dedykowanych trafiają dwa akceleratory AMD: Instinct MI210 i Instinct MI50. Karta jest przekazywana bezpośrednio do Twojego systemu operacyjnego — Twoja kompilacja ROCm, Twoje jądro, Twoje procesy, bez hipernadzorcy pomiędzy.

MI210: 104 jednostki obliczeniowe CDNA 2, 64 GB HBM2e. MI50: 60 jednostek obliczeniowych GCN 5.1, 16 GB. Jeden najemca na maszynę. Bez dzielenia, bez współdzielenia czasu.

Każda karta, którą montujemy — AMD i NVIDIA, obecna i dawno wycofana z produkcji — jest wymieniona z własną ceną miesięczną w katalogu GPU.

Zamień swoje GPU w pasywny miesięczny przychód

Masz nieużywane konfiguracje GPU w serwerze lub komputerze stacjonarnym? Wystaw je już dziś na rynku Primcast i zarabiaj stały miesięczny czynsz od zespołów AI, deweloperów i przedsiębiorstw potrzebujących mocy obliczeniowej klasy produkcyjnej.

Przejdź do Marketplace

Czym naprawdę jest serwer AMD Instinct u nas

Fizyczny serwer wynajmowany jednemu kontu, z akceleratorem AMD w gnieździe PCIe i uprawnieniami root w systemie operacyjnym nad nim. Karta jest pozycją na fakturze, a nie poziomem produktu, więc maszyna pod spodem nie staje się droższa z powodu tego, co jest do niej podłączone.

Karta należy do Ciebie

Bez partycji, bez vGPU, bez harmonogramu decydującego, kiedy nadejdzie Twoja kolej. Akcelerator jest przekazywany bezpośrednio do Twojego jądra, więc sam przypinasz własną wersję ROCm i ładujesz własne moduły bez pytania nas o zgodę.
ROCm, HIP i zwykłe frameworki

Obie części są obsługiwanymi celami ROCm — gfx90a dla MI210, gfx906 dla MI50 — na których PyTorch, TensorFlow, JAX i ONNX Runtime budują na AMD. HIP przenosi kod źródłowy CUDA, zamiast wymagać przepisywania.

Wycena niezależna od maszyny

Akcelerator ma własną miesięczną kwotę, a serwer inną, i dodajesz je do siebie. Wymień kartę bez zmiany serwera. Obie kwoty, dla każdej karty w katalogu, znajdują się na stronie GPU.

Dwa akceleratory AMD Instinct, które montujemy

Oba można zamówić już dziś z tego samego konfiguratora, na różnych liniach serwerów. Poniższe dane to oficjalne dane publikowane przez AMD.

Akcelerator AMD Instinct MI210

AMD Instinct MI210

Generacja CDNA 2 w standardowej karcie PCIe o pełnej wysokości, pełnej długości i dwuslotowej — 104 jednostki obliczeniowe, 64 GB HBM2e z przepustowością do 1,6 TB/s oraz do trzech łączy Infinity Fabric do bezpośredniej komunikacji karta-karta. Chłodzenie pasywne przy 300 W przez łącze hosta PCIe Gen 4. To ta, o którą należy prosić, gdy całe pytanie brzmi, czy model zmieści się w pamięci.

AMD Instinct MI50

Starsza część generacji Vega: układ GCN 5.1, 60 jednostek obliczeniowych i 16 GB pamięci w obudowie. Nikt już nie wynajmuje tej karty, co sprawia, że jest nieosiągalna gdzie indziej, a nie tylko tania tutaj — i nadal jest obsługiwanym celem ROCm, więc uruchamia ten sam kod HIP i PyTorch co MI210 za ułamek miesięcznej kwoty. To rozsądny sposób na uruchomienie łańcucha narzędzi ROCm przed zainwestowaniem w dużą kartę.

Przepustowość macierzowa MI210

AMD publikuje szczytową wydajność macierzową FP16 i BF16 dla MI210 na poziomie 181,0 TFLOPS przy maksymalnym taktowaniu boost 1700 MHz, obok 22,6 TFLOPS szczytowej wydajności wektorowej FP64 i FP32.

Pamięć jest ograniczeniem

64 GB mieści wagi modelu o 30 miliardach parametrów przy 8-bitach lub 13 miliardów przy 16-bitach, z miejscem na pamięć podręczną KV. Dobór rozmiaru modelu to osobne pytanie, a strona LLM przeprowadza te obliczenia dla każdej precyzji.

Co host daje karcie

Generacja linii hosta to fakt, którego prawie nikt nie publikuje, a który decyduje o tym, czy karta działa z projektowaną przepustowością. Publikujemy nasze przy każdej karcie, na stronie GPU.

Nic nie liczy bajtów

Wagi wchodzą, punkty kontrolne wychodzą, zestawy danych wchodzą. Port jest nielimitowany, więc przebieg treningowy przesyłający korpus nie pojawia się jako rachunek za przepustowość na koniec miesiąca.

Serwery dedykowane klasy korporacyjnej dla kart AMD Instinct™

HPE, Dell lub Supermicro

Twoja karta AMD Instinct™ trafia do serwera HPE, Dell lub Supermicro, w zależności od linii, w której ją zamówisz. MI210 można również zamontować w serwerze AMD EPYC budowanym na zamówienie, a serwery dedykowane AMD wyceniają każdy z tych procesorów według liczby rdzeni.

Rozbudowa sprzętu

Łatwo dodawaj zasoby lub dodatkowe serwery do swojej infrastruktury serwerowej. Większość rozbudów jest realizowana w ciągu 24 godzin.

Wsparcie 24/7

Eksperci od serwerów dedykowanych są dostępni 24/7 przez czat na żywo i e-mail.

MI210 w porównaniu z kartami NVIDIA, które również montujemy

Cztery akceleratory z tego samego katalogu zamówień, więc porównuje części, które faktycznie można włożyć do tego samego koszyka. Celowo bez miesięcznych kwot: katalog GPU odczytuje je z katalogu zamówień w momencie żądania, a kwota wpisana do tej tabeli może się zdezaktualizować.

MI210 L40S A100 H100
Architektura GPU CDNA 2 Ada Lovelace NVIDIA Ampere Hopper
Pamięć GPU 64 GB HBM2e 48 GB GDDR6 z ECC 80 GB HBM2e 80 GB HBM2e
Przepustowość pamięci GPU Do 1,6 TB/s 864 GB/s 1935 GB/s 2039 GB/s
FP32 22,6 TFLOPS 91,6 TFLOPS 19,5 TFLOPS 51 TFLOPS
Rdzeń tensorowy TF32 — 366 TFLOPS 312 TFLOPS 756 TFLOPS
Macierz FP16/BF16 181 TFLOPS 733 TFLOPS 624 TFLOPS 1513 TFLOPS
Pobór mocy Do 300 W Do 350 W Do 300 W Do 350 W

TF32 to format rdzeni tensorowych NVIDIA. CDNA 2 go nie implementuje i AMD nie publikuje dla niego żadnej wartości, więc kolumna MI210 nic tam nie pokazuje, zamiast liczby zapożyczonej od innego dostawcy. Wiersze rdzeni tensorowych NVIDIA to opublikowane wartości z rzadkością. Każda inna karta, którą montujemy, w tym MI50, jest wyceniona w katalogu GPU.

FAQ o serwerach GPU AMD Instinct

Częste pytania dotyczące wdrażania i zarządzania akceleratorami AMD Instinct na gołym metalu dla obciążeń AI, HPC i uczenia maszynowego.

Które akceleratory AMD Instinct mogę faktycznie zamówić?

Dwa: Instinct MI210 i Instinct MI50. To akceleratory AMD w naszym katalogu zamówień, a konfigurator nie zaoferuje Ci niczego innego z linii Instinct. MI210 trafia na trzy nasze linie serwerów, a MI50 na dwie. Nie montujemy MI250, MI250X ani MI300A i nigdy tego nie robiliśmy.

Jaka jest różnica między MI210 a MI50?

Generacja i pamięć. MI210 to architektura AMD CDNA 2 ze 104 jednostkami obliczeniowymi i 64 GB HBM2e z przepustowością do 1,6 TB/s, w dwuslotowej karcie PCIe pobierającej do 300 W przez łącze hosta PCIe Gen 4, z maksymalnie trzema łączami Infinity Fabric do komunikacji karta-karta. MI50 to wcześniejsza generacja GCN 5.1 z 60 jednostkami obliczeniowymi i 16 GB. Oba są obsługiwanymi celami ROCm, więc ten sam kod HIP i PyTorch działa na obu — MI210 po prostu mieści cztery razy więcej modelu.

Ile pamięci karty potrzebuje model, który chcę uruchomić?

Same wagi to parametry pomnożone przez bajty na parametr: około 16 GB dla modelu o 7-8 miliardach parametrów przy 16-bitach, 28 GB dla 13-14 miliardów, 68 GB dla 30-34 miliardów. Do tego dochodzą pamięć podręczna KV i środowisko uruchomieniowe, dlatego karta 16 GB nie obsłuży wygodnie modelu, którego wagi mają 16 GB. 64 GB MI210 pokrywa model 30-miliardowy skwantowany do 8-bitów z miejscem na pracę. Strona doboru rozmiaru LLM ma całą tabelę — ile pamięci potrzebuje każdy rozmiar modelu i która karta to obsłuży.

Ile trwa wdrożenie serwera GPU AMD Instinct?

Gdy maszyna jest już w szafie, zwykle jest aktywowana około 30 minut po zaksięgowaniu płatności. Gdy jej nie ma, jest budowana na zamówienie, a czas realizacji zależy od części. Zapytaj przed zapłatą, jeśli termin ma znaczenie — serwery natychmiastowe to strona z tym, co stoi teraz w szafie. Każdy serwer zawiera natychmiastowe przeładowanie systemu operacyjnego, więc możesz iterować bez ponownego otwierania zgłoszenia.

Jakie oprogramowanie i frameworki działają na tych kartach?

ROCm, otwarta platforma obliczeniowa GPU firmy AMD. Obie części są obsługiwanymi celami ROCm — gfx90a na MI210, gfx906 na MI50 — co obejmuje PyTorch, TensorFlow, JAX i ONNX Runtime, wraz z bibliotekami BLAS, FFT, RNG i prymitywów głębokiego uczenia. HIP przenosi istniejący kod źródłowy CUDA, zamiast wymagać przepisywania. Ponieważ masz uprawnienia root na gołym metalu, sam wybierasz wersje ROCm i jądra i możesz uruchomić całość w Dockerze lub pod Kubernetesem.