
Wykrywanie obiektów, klasyfikacja i segmentacja to zadania, do których te części zostały zbudowane. Sieci są małe i skwantyzowane do int8 — klasa MobileNet i EfficientDet, kompilowana dla modułu z wyprzedzeniem — i odpowiadają w milisekundach na maszynie, która przechowuje klatki.
Oba moduły pobierają jednocyfrową liczbę watów, więc strumień z kamery lub czujnika może być analizowany przez całą dobę bez obciążania procesora hosta. Rdzenie pozostają wolne dla Twojej aplikacji; moduł wykonuje obliczenia.
Model mierzony w miliardach parametrów nie mieści się w żadnym z tych modułów, przy żadnej kwantyzacji, i ta strona nie będzie udawać, że jest inaczej. Dobór rozmiaru modelu językowego to osobne obliczenia i znajdują się na stronie czego potrzeba, aby uruchomić model; dedykowane karty, które faktycznie go uruchamiają, każda wyceniona przy swojej maszynie, są na stronie serwery dedykowane GPU.
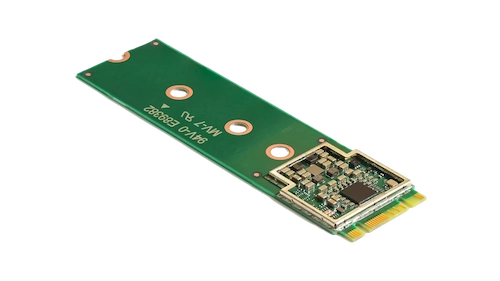
Moduł Coral firmy Google zawiera Edge TPU, który Google ocenia na 4 biliony operacji na sekundę na 8-bitowych liczbach całkowitych przy około dwóch watach. Są to dane producenta, cytowane zgodnie z publikacją — nie nasz pomiar.
Uruchamia modele TensorFlow Lite, które zostały skwantyzowane do int8 i wcześniej skompilowane dla Edge TPU. Ten krok kompilacji to uczciwy koszt tej części: model albo się dla niej kompiluje, albo nie, a klasyczne sieci brzegowe — klasyfikacja, detekcja, pozycja — to te, które się kompilują.
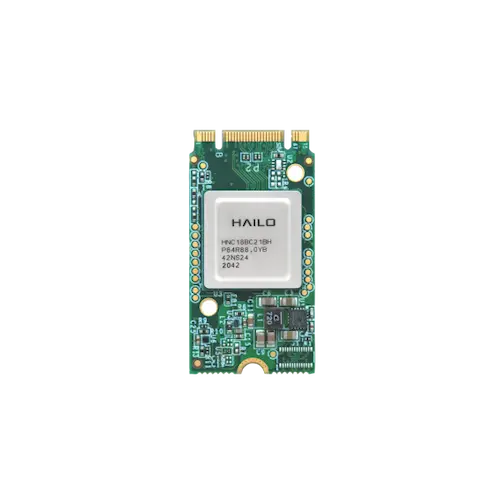
Hailo ocenia Hailo-8 na maksymalnie 26 tera-operacji na sekundę na 8-bitowych liczbach całkowitych — ponownie dane producenta, cytowane zgodnie z publikacją. To znacznie większy z dwóch modułów i ten, o który należy prosić, gdy sieć wielkości Coral nie wystarcza.
Modele trafiają do niego z TensorFlow lub ONNX przez własny kompilator Hailo, a jego środowisko uruchomieniowe obsługuje je na Twojej maszynie. Podobnie jak w przypadku Coral, krok kompilacji decyduje o tym, co działa: to część do sieci neuronowych, a nie obliczeń ogólnego przeznaczenia.

Moduł nie jest osobnym produktem: to jedna pozycja w konfiguratorze kasety, dodawana do kwoty samej maszyny. Żadna z tych liczb nie jest tu wpisana, ponieważ cena należy obok maszyny, z którą jest dostarczana — ta sama zasada obowiązuje na każdej stronie w tej rodzinie.
Gniazdo M.2 znajduje się na kasecie HPE Moonshot. Skonfiguruj m710x (czterordzeniowy Xeon E3-1585L v5) lub m510 (Xeon D, osiem lub szesnaście rdzeni) i dodaj moduł jako opcję.
Maszyna należy wyłącznie do Ciebie, z uprawnieniami root. Środowisko uruchomieniowe producenta — TensorFlow Lite z biblioteką Edge TPU dla Coral, HailoRT firmy Hailo dla Hailo-8 — instaluje się w Twoim systemie operacyjnym i pozostaje w wersji, którą przypniesz. Nic nie aktualizuje się pod Tobą.
Krok w górę to nie większy moduł; to dedykowana karta w maszynie zbudowanej do jej obsługi. Serwery dedykowane GPU to każda karta, którą montujemy, wyceniona przy swojej maszynie; wiele GPU i wiele węzłów to więcej niż jedna.










