
Detecção de objetos, classificação e segmentação são o que estas peças foram feitas para fazer. As redes são pequenas e quantizadas em int8 — da classe MobileNet e EfficientDet, compiladas para o módulo com antecedência — e respondem em milissegundos na máquina que guarda os quadros.
Ambos os módulos consomem watts de um dígito, então um feed de câmera ou um fluxo de sensores pode ser avaliado o tempo todo sem ocupar o processador host. Os núcleos ficam livres para a sua aplicação; o módulo faz a aritmética.
Um modelo medido em bilhões de parâmetros não cabe em nenhum dos dois módulos, em qualquer quantização, e esta página não vai fingir o contrário. Dimensionar um modelo de linguagem é uma aritmética própria e vive em o que é preciso para executar um modelo; as placas discretas que de fato executam um, cada uma com preço ao lado da sua máquina, estão em servidores dedicados com GPU.
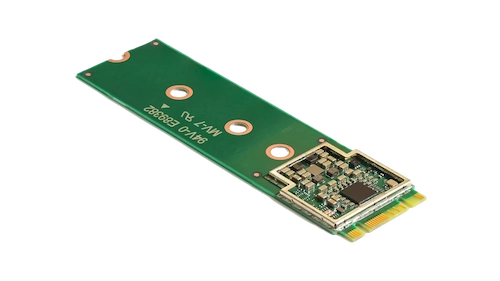
O módulo Coral do Google carrega o Edge TPU, que o Google classifica em 4 trilhões de operações por segundo em inteiros de 8 bits a cerca de dois watts. Esses são os números do fabricante, citados como publicados — não uma medição nossa.
Ele executa modelos TensorFlow Lite que foram quantizados para int8 e compilados para o Edge TPU com antecedência. Essa etapa de compilação é o custo honesto da peça: um modelo ou compila para ela ou não compila, e as redes de borda clássicas — classificação, detecção, pose — são as que compilam.
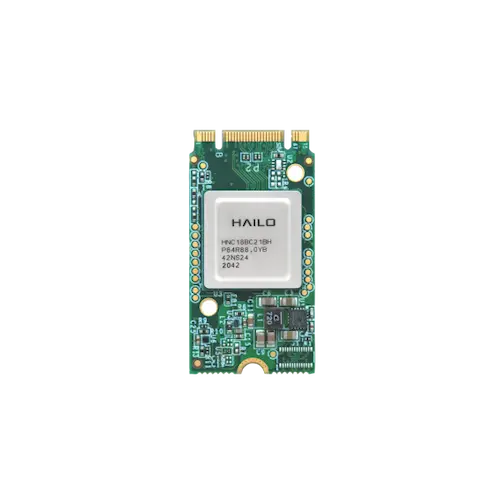
A Hailo classifica o Hailo-8 em até 26 tera-operações por segundo em inteiros de 8 bits — novamente o número do fabricante, citado como publicado. É o maior dos dois módulos com folga, e é o que se deve pedir quando uma rede do tamanho do Coral não é suficiente.
Os modelos chegam a ele a partir do TensorFlow ou do ONNX pelo compilador da própria Hailo, e o runtime dela os serve na sua máquina. Como no Coral, a etapa de compilação decide o que executa: esta é uma peça de rede neural, não computação de uso geral.

O módulo não é uma categoria de produto: é uma linha no configurador do cartucho, somada ao valor da própria máquina. Nenhum dos dois números é digitado aqui, porque um preço pertence ao lado da máquina com a qual ele vem — a mesma regra que toda página desta família segue.
O slot M.2 fica em um cartucho HPE Moonshot. Configure o m710x (Xeon E3-1585L v5 quad-core) ou o m510 (Xeon D, oito ou dezesseis núcleos) e adicione o módulo como opção.
A máquina é somente sua, com root. O runtime do fabricante — TensorFlow Lite com a biblioteca Edge TPU para o Coral, o HailoRT da Hailo para o Hailo-8 — instala no seu sistema operacional e permanece na versão que você fixar. Nada é atualizado por baixo de você.
O passo acima não é um módulo maior; é uma placa discreta em uma máquina feita para recebê-la. Servidores dedicados com GPU é cada placa que instalamos, com preço ao lado da sua máquina; multi-GPU e multi-nó é mais de uma.










