A placa é sua
Sem partição, sem vGPU, sem agendador decidindo quando é a sua vez. O acelerador é entregue diretamente ao seu kernel, então você fixa sua própria versão do ROCm e carrega seus próprios módulos sem nos perguntar.
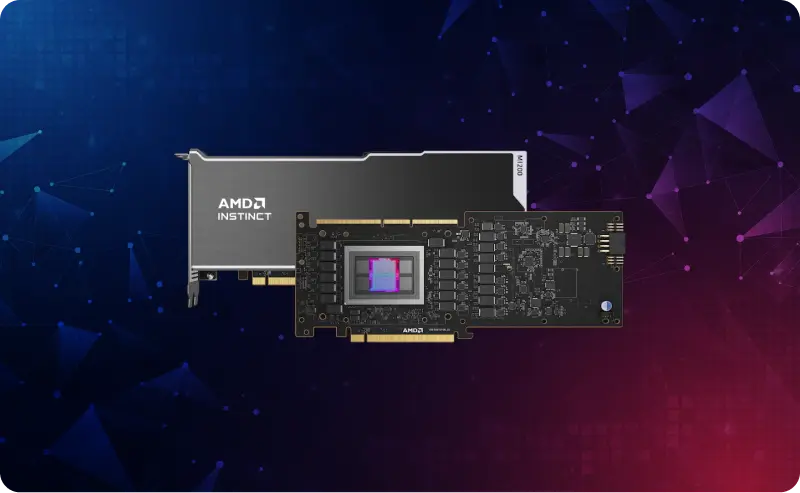
Dois aceleradores AMD entram em nossos servidores dedicados: o Instinct MI210 e o Instinct MI50. A placa é passada diretamente para o seu próprio sistema operacional — sua compilação ROCm, seu kernel, seus processos, e nenhum hypervisor no meio.
Proprietários anunciam suas máquinas AMD Instinct em nosso marketplace e definem seu próprio preço mensal. Uma placa que diz estar listada por meio de nossa empresa irmã, Server Room, é alugada em serverroom.net e não aqui.
Um servidor físico alugado para uma conta, com um acelerador AMD em um slot PCIe e root no sistema operacional acima dele. A placa é uma linha na fatura, não um nível de produto, então a máquina por baixo não fica mais cara por causa do que está conectado a ela.
Ambos podem ser encomendados hoje no mesmo configurador, em linhas de servidor diferentes. Os números abaixo são os publicados pela própria AMD.
Quatro aceleradores do mesmo catálogo de pedidos, então isto compara peças que você pode de fato colocar no mesmo carrinho. Sem valores mensais aqui de propósito: o catálogo de GPUs os lê do catálogo de pedidos no momento da solicitação, e um valor digitado nesta tabela pode ficar desatualizado.
| MI210 | L40S | A100 | H100 | |
|---|---|---|---|---|
| Arquitetura da GPU | CDNA 2 | Ada Lovelace | NVIDIA Ampere | Hopper |
| Memória da GPU | 64GB HBM2e | 48GB GDDR6 com ECC | 80GB HBM2e | 80GB HBM2e |
| Largura de banda da memória da GPU | Até 1,6 TB/s | 864 GB/s | 1935 GB/s | 2039 GB/s |
| FP32 | 22,6 TFLOPS | 91,6 TFLOPS | 19,5 TFLOPS | 51 TFLOPS |
| Núcleo Tensor TF32 | — | 366 TFLOPS | 312 TFLOPS | 756 TFLOPS |
| Matriz FP16/BF16 | 181 TFLOPS | 733 TFLOPS | 624 TFLOPS | 1513 TFLOPS |
| Potência | Até 300W | Até 350W | Até 300W | Até 350W |
Perguntas comuns sobre implantação e gerenciamento de aceleradores AMD Instinct em bare metal para cargas de trabalho de IA, HPC e aprendizado de máquina.