Acceleratori AMD Instinct

AMD Instinct su una macchina su cui nessun altro è

Due acceleratori AMD entrano nei nostri server dedicati: l'Instinct MI210 e l'Instinct MI50. La scheda viene passata direttamente al tuo sistema operativo — la tua build ROCm, il tuo kernel, i tuoi processi, e nessun hypervisor in mezzo.

MI210: 104 unità di calcolo CDNA 2, 64 GB HBM2e. MI50: 60 unità di calcolo GCN 5.1, 16 GB. Un solo tenant per macchina. Non suddivisa, non condivisa a tempo.

Ogni scheda che installiamo — AMD e NVIDIA, attuali e fuori produzione da tempo — è elencata con il proprio prezzo mensile nel catalogo GPU.

Trasforma le tue GPU in entrate mensili passive

Hai configurazioni GPU server o desktop inattive? Mettile in vendita oggi sul marketplace Primcast e guadagna affitti mensili costanti da team AI, sviluppatori e aziende che necessitano di calcolo di livello produttivo.

Vai al Marketplace

Cos'è realmente un server AMD Instinct qui

Un server fisico noleggiato a un solo account, con un acceleratore AMD in uno slot PCIe e accesso root al sistema operativo sovrastante. La scheda è una voce in fattura piuttosto che un livello di prodotto, quindi la macchina sottostante non diventa più costosa a causa di ciò che vi è collegato.

La scheda è tua

Nessuna partizione, nessuna vGPU, nessuno scheduler che decide quando tocca a te. L'acceleratore viene consegnato direttamente al tuo kernel, così blocchi la tua versione di ROCm e carichi i tuoi moduli senza chiedere a noi.

ROCm, HIP e i framework abituali

Entrambi i componenti sono target ROCm supportati — gfx90a per il MI210, gfx906 per il MI50 — ovvero ciò su cui PyTorch, TensorFlow, JAX e ONNX Runtime compilano su AMD. HIP trasferisce il codice sorgente CUDA senza richiedere una riscrittura.

Prezzo separato dalla macchina

L'acceleratore ha una propria cifra mensile e il server ne ha un'altra, e tu sommi le due. Sostituisci la scheda senza cambiare server. Entrambe le cifre, per ogni scheda del catalogo, sono sulla pagina GPU.

I due acceleratori AMD Instinct che installiamo

Entrambi sono ordinabili oggi dallo stesso configuratore, su linee di server diverse. Le cifre riportate di seguito sono quelle pubblicate da AMD.
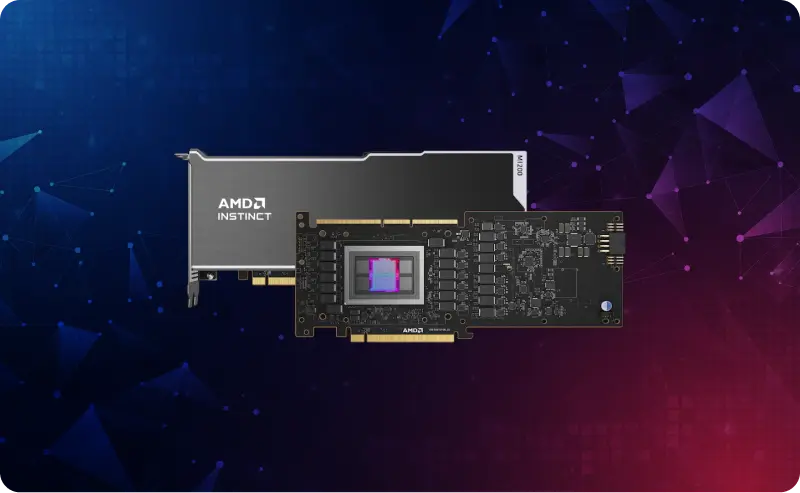
Acceleratore AMD Instinct MI210

AMD Instinct MI210

La generazione CDNA 2 in una scheda PCIe standard full-height, full-length, a doppio slot — 104 unità di calcolo, 64 GB di HBM2e fino a 1,6 TB/s e fino a tre collegamenti Infinity Fabric per il traffico diretto tra schede. Raffreddata passivamente a 300 W su un collegamento host PCIe Gen 4. È quella da richiedere quando l'intera questione è se il modello entra in memoria.

AMD Instinct MI50

Il componente più vecchio della generazione Vega: silicio GCN 5.1, 60 unità di calcolo e 16 GB di memoria on-package. Nessuno noleggia più questa scheda, il che la rende introvabile altrove piuttosto che semplicemente economica qui — ed è ancora un target ROCm supportato, quindi esegue lo stesso codice HIP e PyTorch del MI210 per una frazione della cifra mensile. È il modo sensato per far funzionare una toolchain ROCm prima di impegnarsi con la scheda grande.

Throughput matriciale sul MI210

AMD pubblica 181,0 TFLOPS di picco FP16 e BF16 per le prestazioni matriciali del MI210 alla sua frequenza di boost massima di 1.700 MHz, insieme a 22,6 TFLOPS di picco FP64 e FP32 vettoriale.

La memoria è il vincolo

64 GB contengono i pesi di un modello da 30 miliardi di parametri a 8 bit, o da 13 miliardi a 16 bit, con spazio residuo per la cache KV. Dimensionare un modello è una questione a sé, e la pagina LLM svolge questa aritmetica a ogni precisione.

Cosa offre l'host alla scheda

La generazione delle linee host è il dato che quasi nessuno pubblica ed è quello che determina se una scheda funziona alla sua larghezza di banda di progetto. Noi pubblichiamo i nostri accanto a ogni scheda, sulla pagina GPU.

Nessuno conta i byte

Pesi in entrata, checkpoint in uscita, dataset in entrata. La porta non è misurata, quindi un ciclo di addestramento che trasmette un corpus non arriva come bolletta della larghezza di banda a fine mese.

Server dedicati di livello enterprise per schede AMD Instinct™

HPE, Dell o Supermicro

La tua scheda AMD Instinct™ viene installata in un server HPE, Dell o Supermicro, a seconda della linea su cui la ordini. La MI210 può essere installata anche in un server AMD EPYC costruito su ordinazione, e i server dedicati AMD prezzano ciascuno di questi processori in base al core.

Aggiornamenti hardware

Aggiungi facilmente risorse o server aggiuntivi alla tua infrastruttura server. La maggior parte degli aggiornamenti viene elaborata entro 24 ore.

Supporto 24/7

Esperti di server dedicati sono disponibili ad assisterti 24/7 tramite chat dal vivo ed e-mail.

Il MI210 rispetto alle schede NVIDIA che installiamo anche

Quattro acceleratori dallo stesso catalogo ordini, quindi questo confronta componenti che puoi effettivamente mettere nello stesso carrello. Nessuna cifra mensile qui di proposito: il catalogo GPU le legge dal catalogo ordini al momento della richiesta, e una cifra digitata in questa tabella può diventare obsoleta.

MI210 L40S A100 H100
Architettura GPU CDNA 2 Ada Lovelace NVIDIA Ampere Hopper
Memoria GPU 64GB HBM2e 48GB GDDR6 con ECC 80GB HBM2e 80GB HBM2e
Larghezza di banda memoria GPU Fino a 1,6 TB/s 864 GB/s 1935 GB/s 2039 GB/s
FP32 22,6 TFLOPS 91,6 TFLOPS 19,5 TFLOPS 51 TFLOPS
TF32 Tensor Core — 366 TFLOPS 312 TFLOPS 756 TFLOPS
Matrice FP16/BF16 181 TFLOPS 733 TFLOPS 624 TFLOPS 1513 TFLOPS
Potenza Fino a 300W Fino a 350W Fino a 300W Fino a 350W

TF32 è un formato tensor core NVIDIA. CDNA 2 non lo implementa e AMD non pubblica alcuna cifra al riguardo, quindi la colonna MI210 non mostra nulla lì piuttosto che un numero preso in prestito da un altro fornitore. Le righe dei tensor core NVIDIA sono le cifre pubblicate con sparsità. Ogni altra scheda che installiamo, incluso il MI50, ha un prezzo nel catalogo GPU.

FAQ sui server GPU AMD Instinct

Domande comuni sull'implementazione e la gestione degli acceleratori AMD Instinct su bare metal per carichi di lavoro AI, HPC e machine learning.

Quali acceleratori AMD Instinct posso effettivamente ordinare?

Due: l'Instinct MI210 e l'Instinct MI50. Questi sono gli acceleratori AMD nel nostro catalogo ordini, e il configuratore non ti offrirà nient'altro della linea Instinct. Il MI210 è disponibile su tre delle nostre linee di server e il MI50 su due. Non installiamo il MI250, il MI250X o il MI300A, e non l'abbiamo mai fatto.

Qual è la differenza tra il MI210 e il MI50?

Generazione e memoria. Il MI210 è l'architettura CDNA 2 di AMD con 104 unità di calcolo e 64 GB di HBM2e fino a 1,6 TB/s, in una scheda PCIe a doppio slot che assorbe fino a 300 W su un collegamento host PCIe Gen 4, con fino a tre collegamenti Infinity Fabric per il traffico tra schede. Il MI50 è la precedente generazione GCN 5.1 con 60 unità di calcolo e 16 GB. Entrambi sono target ROCm supportati, quindi lo stesso codice HIP e PyTorch gira su entrambi — il MI210 contiene semplicemente quattro volte tanto di un modello.

Quanta memoria della scheda richiede il modello che voglio eseguire?

I soli pesi sono parametri moltiplicati per byte per parametro: circa 16 GB per un modello da 7-8 miliardi di parametri a 16 bit, 28 GB per 13-14 miliardi, 68 GB per 30-34 miliardi. La cache KV e il runtime si aggiungono a questo, motivo per cui una scheda da 16 GB non serve comodamente un modello i cui pesi sono 16 GB. I 64 GB del MI210 coprono un modello da 30 miliardi quantizzato a 8 bit con spazio per lavorare. La pagina di dimensionamento LLM ha l'intera tabella — quanta memoria richiede ogni dimensione di modello e quale scheda la soddisfa.

Quanto tempo richiede l'implementazione di un server GPU AMD Instinct?

Dove la macchina è già installata in rack viene tipicamente attivata circa 30 minuti dopo la conferma del pagamento. Dove non lo è, viene costruita su ordinazione e il tempo di consegna dipende dai componenti. Chiedi prima di pagare se la data è importante — server istantanei è la pagina per ciò che è in rack in questo momento. Ogni server include il riavvio istantaneo del sistema operativo, così puoi iterare senza riaprire un ticket.

Quali software e framework girano su queste schede?

ROCm, la piattaforma di calcolo GPU open-source di AMD. Entrambi i componenti sono target ROCm supportati — gfx90a sul MI210, gfx906 sul MI50 — il che copre PyTorch, TensorFlow, JAX e ONNX Runtime, insieme alle librerie primitive BLAS, FFT, RNG e deep-learning. HIP trasferisce il codice sorgente CUDA esistente senza richiedere una riscrittura. Poiché hai accesso root su bare metal scegli tu stesso le versioni di ROCm e del kernel, e puoi eseguire il tutto in Docker o sotto Kubernetes.