
Objekterkennung, Klassifizierung und Segmentierung sind die Aufgaben, für die diese Bauteile gebaut wurden. Die Netzwerke sind klein und int8-quantisiert — aus der MobileNet- und EfficientDet-Klasse, vorab für das Modul kompiliert — und antworten in Millisekunden auf der Maschine, die die Frames hält.
Beide Module ziehen einstellige Watt, sodass ein Kamera-Feed oder ein Sensorstrom rund um die Uhr ausgewertet werden kann, ohne den Host-Prozessor zu belasten. Die Kerne bleiben für Ihre Anwendung frei; das Modul übernimmt die Rechenarbeit.
Ein Modell mit Milliarden von Parametern passt in kein der beiden Module, bei keiner Quantisierung, und diese Seite wird nichts anderes behaupten. Die Dimensionierung eines Sprachmodells ist eine eigene Rechenaufgabe und findet sich unter Was es braucht, um ein Modell auszuführen; die diskreten Karten, die tatsächlich eines ausführen, jeweils mit Preis neben ihrer Maschine, finden Sie unter GPU-dedizierte Server.
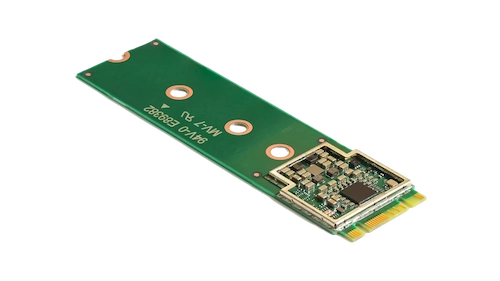
Googles Coral-Modul trägt die Edge TPU, die Google mit 4 Billionen Operationen pro Sekunde bei 8-Bit-Ganzzahlen und rund zwei Watt angibt. Das sind die Herstellerangaben, zitiert wie veröffentlicht — keine eigene Messung von uns.
Es führt TensorFlow-Lite-Modelle aus, die zuvor auf int8 quantisiert und für die Edge TPU kompiliert wurden. Dieser Kompilierungsschritt ist der ehrliche Preis des Bauteils: Ein Modell lässt sich entweder dafür kompilieren oder nicht, und die klassischen Edge-Netzwerke — Klassifizierung, Erkennung, Pose — sind diejenigen, die es tun.
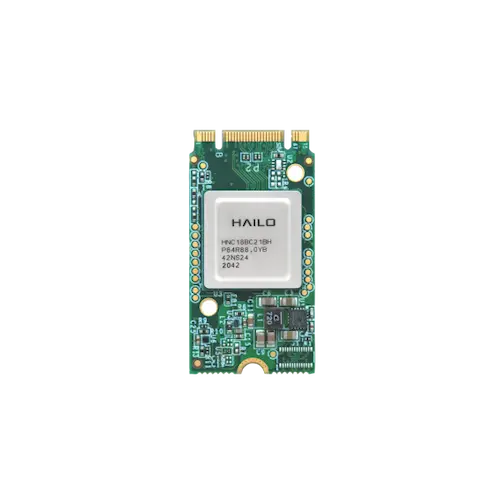
Hailo gibt den Hailo-8 mit bis zu 26 Tera-Operationen pro Sekunde bei 8-Bit-Ganzzahlen an — auch hier die Herstellerangabe, zitiert wie veröffentlicht. Es ist das deutlich größere der beiden Module und die richtige Wahl, wenn ein Coral-großes Netzwerk nicht ausreicht.
Modelle erreichen es aus TensorFlow oder ONNX über Hailos eigenen Compiler, und seine Laufzeitumgebung bedient sie auf Ihrer Maschine. Wie beim Coral entscheidet der Kompilierungsschritt, was läuft: Dies ist ein Bauteil für neuronale Netze, keine universelle Rechenleistung.

Das Modul ist keine Produktstufe: Es ist eine Zeile im Konfigurator des Cartridges, hinzugefügt zum Preis der Maschine selbst. Keine der beiden Zahlen wird hier genannt, denn ein Preis gehört neben die Maschine, mit der er kommt — dieselbe Regel, der jede Seite dieser Familie folgt.
Der M.2-Steckplatz sitzt auf einem HPE-Moonshot-Cartridge. Konfigurieren Sie den m710x (Quad-Core Xeon E3-1585L v5) oder den m510 (Xeon D, acht oder sechzehn Kerne) und fügen Sie das Modul als Option hinzu.
Die Maschine gehört Ihnen allein, mit Root-Zugriff. Die Laufzeitumgebung des Herstellers — TensorFlow Lite mit der Edge TPU-Bibliothek für den Coral, Hailos HailoRT für den Hailo-8 — installiert sich auf Ihrem Betriebssystem und bleibt auf der von Ihnen festgelegten Version. Nichts wird unter Ihnen stillschweigend aktualisiert.
Der nächste Schritt ist kein größeres Modul, sondern eine diskrete Karte in einer Maschine, die dafür gebaut ist. GPU-dedizierte Server umfasst jede Karte, die wir einbauen, mit Preis neben ihrer Maschine; Multi-GPU und Multi-Node ist mehr als eine.










