
Detectarea obiectelor, clasificarea și segmentarea sunt scopul pentru care au fost construite aceste componente. Rețelele sunt mici și cuantizate int8 — clasa MobileNet și EfficientDet, compilate pentru modul din timp — și răspund în milisecunde pe mașina care deține cadrele.
Ambele module consumă sub zece wați, astfel încât un flux de cameră sau un flux de senzori poate fi evaluat non-stop fără a ocupa procesorul gazdă. Nucleele rămân libere pentru aplicația ta; modulul face calculele.
Un model măsurat în miliarde de parametri nu încape pe niciunul dintre module, la nicio cuantizare, iar această pagină nu va pretinde altceva. Dimensionarea unui model de limbaj este un calcul propriu și se găsește la ce presupune rularea unui model; plăcile discrete care rulează unul, fiecare cu prețul afișat lângă mașina sa, sunt la servere dedicate GPU.
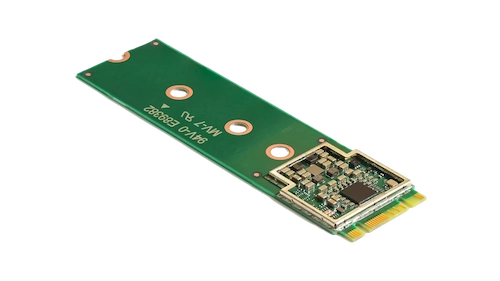
Modulul Coral de la Google’s include Edge TPU, pe care Google îl evaluează la 4 trilioane de operații pe secundă pe numere întregi de 8 biți, la aproximativ doi wați. Acestea sunt cifrele producătorului, citate așa cum au fost publicate — nu o măsurătoare a noastră.
Rulează modele TensorFlow Lite care au fost cuantizate la int8 și compilate pentru Edge TPU din timp. Acest pas de compilare este costul onest al componentei: un model fie se compilează pentru ea, fie nu, iar rețelele edge clasice — clasificare, detecție, estimare de poziție — sunt cele care se compilează.
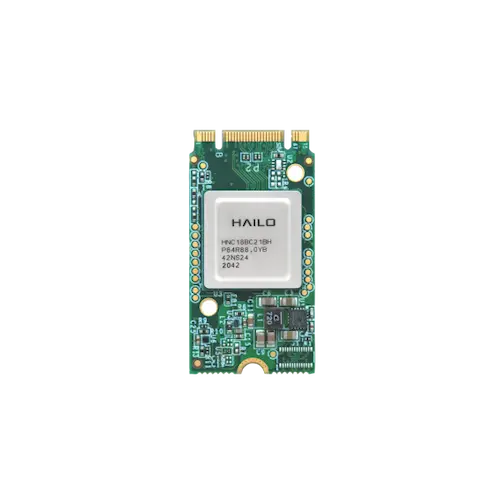
Hailo evaluează Hailo-8 la până la 26 de tera-operații pe secundă pe numere întregi de 8 biți — din nou cifra producătorului, citată așa cum a fost publicată. Este cel mai mare dintre cele două module, cu o marjă considerabilă, și cel pe care îl ceri atunci când o rețea de dimensiunea Coral nu este suficientă.
Modelele ajung la el din TensorFlow sau ONNX prin compilatorul propriu al Hailo’s, iar runtime-ul său le servește pe mașina ta. Ca și în cazul Coral, pasul de compilare decide ce rulează: aceasta este o componentă de rețea neuronală, nu de calcul de uz general.

Modulul nu este un nivel de produs: este o singură linie în configuratorul cartușului, adăugată la suma mașinii. Niciun număr nu este scris aici, deoarece un preț aparține lângă mașina cu care vine — aceeași regulă pe care o urmează fiecare pagină din această familie.
Slotul M.2 se află pe un cartuș HPE Moonshot. Configurează m710x (Xeon E3-1585L v5 quad-core) sau m510 (Xeon D, opt sau șaisprezece nuclee) și adaugă modulul ca opțiune.
Mașina este doar a ta, cu acces root. Runtime-ul producătorului — TensorFlow Lite cu biblioteca Edge TPU pentru Coral, HailoRT de la Hailo pentru Hailo-8 — se instalează pe sistemul tău de operare și rămâne la versiunea pe care o fixezi. Nimic nu se actualizează pe sub tine.
Pasul următor nu este un modul mai mare; este o placă discretă într-o mașină construită să o accepte. Servere dedicate GPU reprezintă fiecare placă pe care o montăm, cu prețul afișat lângă mașina sa; multi-GPU și multi-nod înseamnă mai mult de una.










