
Rilevamento di oggetti, classificazione e segmentazione sono ciò per cui questi componenti sono stati costruiti. Le reti sono piccole e quantizzate in int8 — della classe MobileNet ed EfficientDet, compilate in anticipo per il modulo — e rispondono in millisecondi sulla macchina che conserva i fotogrammi.
Entrambi i moduli assorbono pochi watt, quindi un flusso video o un flusso di sensori può essere elaborato 24 ore su 24 senza occupare il processore host. I core restano liberi per la tua applicazione; il modulo fa i calcoli.
Un modello misurato in miliardi di parametri non entra in nessuno dei due moduli, a qualsiasi quantizzazione, e questa pagina non fingerà il contrario. Dimensionare un modello linguistico è un calcolo a sé e si trova su cosa serve per eseguire un modello; le schede discrete che ne eseguono uno, ciascuna con il prezzo accanto alla propria macchina, sono su server dedicati GPU.
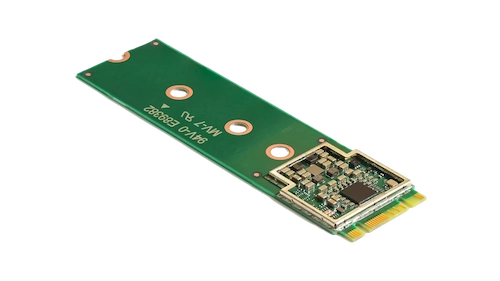
Il modulo Coral di Google’ monta l’Edge TPU, che Google valuta a 4 trilioni di operazioni al secondo su interi a 8 bit a circa due watt. Sono le cifre del produttore, citate come pubblicate — non una nostra misurazione.
Esegue modelli TensorFlow Lite quantizzati in int8 e compilati in anticipo per l’Edge TPU. Quel passaggio di compilazione è il costo onesto del componente: un modello o si compila per esso oppure no, e le classiche reti edge — classificazione, rilevamento, posa — sono quelle che ci riescono.
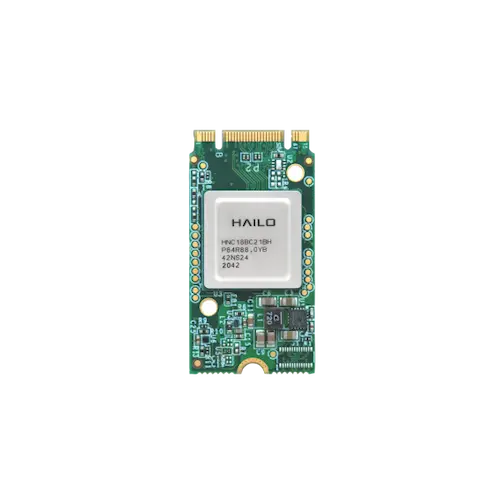
Hailo valuta l’Hailo-8 fino a 26 tera-operazioni al secondo su interi a 8 bit — anche in questo caso la cifra del produttore, citata come pubblicata. È il più grande dei due moduli di gran lunga, ed è quello da richiedere quando una rete di dimensioni Coral non basta.
I modelli vi arrivano da TensorFlow o ONNX tramite il compilatore di Hailo, e il suo runtime li serve sulla tua macchina. Come per il Coral, il passaggio di compilazione decide cosa gira: questo è un componente per reti neurali, non calcolo generico.

Il modulo non è una fascia di prodotto: è una riga nel configuratore della cartuccia, aggiunta alla cifra della macchina. Nessuno dei due numeri è digitato qui, perché un prezzo appartiene accanto alla macchina con cui viene fornito — la stessa regola che segue ogni pagina di questa famiglia.
Lo slot M.2 si trova su una cartuccia HPE Moonshot. Configura la m710x (Xeon E3-1585L v5 quad-core) o la m510 (Xeon D, otto o sedici core) e aggiungi il modulo come opzione.
La macchina è solo tua, con root. Il runtime del produttore — TensorFlow Lite con la libreria Edge TPU per il Coral, HailoRT di Hailo per l’Hailo-8 — si installa sul tuo sistema operativo e resta alla versione che blocchi. Nulla si aggiorna sotto di te.
Il passo successivo non è un modulo più grande; è una scheda discreta in una macchina costruita per ospitarla. Server dedicati GPU è ogni scheda che installiamo, con il prezzo accanto alla sua macchina; multi-GPU e multi-nodo è più di una.










