










AMD Instinct Beschleuniger

AMD Instinct auf einer Maschine, auf der sonst niemand ist

Zwei AMD-Beschleuniger stecken in unseren dedizierten Servern: der Instinct MI210 und der Instinct MI50. Die Karte wird direkt an Ihr eigenes Betriebssystem durchgereicht — Ihr ROCm-Build, Ihr Kernel, Ihre Prozesse, und kein Hypervisor dazwischen.

MI210: 104 CDNA-2-Recheneinheiten, 64 GB HBM2e. MI50: 60 GCN-5.1-Recheneinheiten, 16 GB. Ein Mandant pro Maschine. Nicht aufgeteilt, nicht im Time-Sharing.

Jede Karte, die wir einbauen — AMD und NVIDIA, aktuelle und längst nicht mehr produzierte — ist mit ihrem eigenen monatlichen Preis im GPU-Katalog aufgeführt.

Verwandeln Sie Ihre GPUs in passives monatliches Einkommen

Haben Sie ungenutzte Server- oder Desktop-GPU-Setups? Listen Sie sie noch heute auf dem Primcast-Marktplatz und erzielen Sie stetige monatliche Mieteinnahmen von KI-Teams, Entwicklern und Unternehmen, die Compute-Kapazität in Produktionsqualität benötigen.

Zum Marktplatz

Was ein AMD-Instinct-Server hier tatsächlich ist

Ein physischer Server, der an ein einziges Konto vermietet wird, mit einem AMD-Beschleuniger in einem PCIe-Steckplatz und Root-Rechten auf dem darüber liegenden Betriebssystem. Die Karte ist eine Position auf der Rechnung und keine Produktstufe, sodass die darunterliegende Maschine nicht teurer wird, nur weil etwas eingesteckt ist.

Die Karte gehört Ihnen

Keine Partition, keine vGPU, kein Scheduler, der entscheidet, wann Sie an der Reihe sind. Der Beschleuniger wird direkt an Ihren Kernel übergeben, sodass Sie Ihre eigene ROCm-Version festlegen und Ihre eigenen Module laden können, ohne uns zu fragen.
ROCm, HIP und die üblichen Frameworks

Beide Teile sind unterstützte ROCm-Ziele — gfx90a für den MI210, gfx906 für den MI50 — und genau darauf bauen PyTorch, TensorFlow, JAX und ONNX Runtime unter AMD auf. HIP portiert CUDA-Quellcode, statt eine Neuimplementierung zu erfordern.

Getrennt von der Maschine bepreist

Der Beschleuniger hat seinen eigenen monatlichen Betrag und der Server einen weiteren, und Sie addieren beide. Wechseln Sie die Karte, ohne den Server zu wechseln. Beide Beträge für jede Karte im Katalog finden Sie auf der GPU-Seite.

Die zwei AMD-Instinct-Beschleuniger, die wir einbauen

Beide sind heute über denselben Konfigurator bestellbar, auf unterschiedlichen Serverlinien. Die folgenden Zahlen sind die von AMD selbst veröffentlichten.

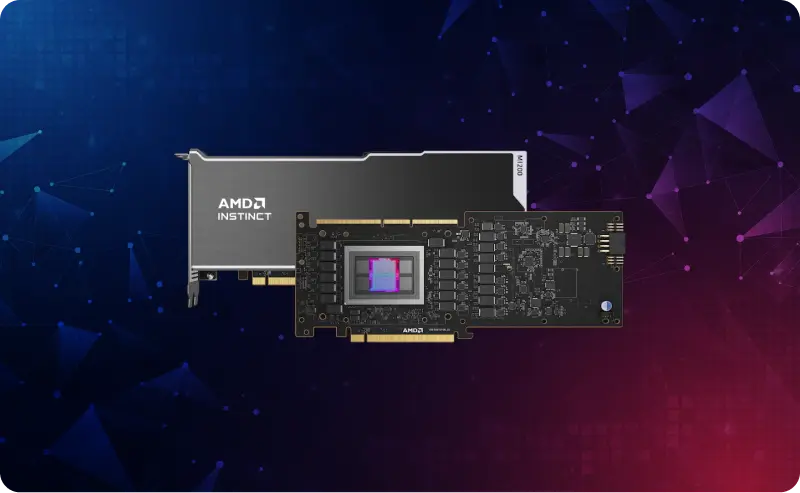
AMD Instinct MI210 Beschleuniger

AMD Instinct MI210

Die CDNA-2-Generation als Standard-PCIe-Karte in voller Bauhöhe, voller Länge und mit zwei Steckplätzen — 104 Recheneinheiten, 64 GB HBM2e mit bis zu 1,6 TB/s und bis zu drei Infinity-Fabric-Verbindungen für direkten Karte-zu-Karte-Verkehr. Passiv gekühlt bei 300 W über eine PCIe-Gen-4-Hostverbindung. Dies ist die Karte, nach der Sie fragen sollten, wenn die ganze Frage lautet, ob das Modell in den Speicher passt.

AMD Instinct MI50

Das ältere Teil der Vega-Generation: GCN-5.1-Silizium, 60 Recheneinheiten und 16 GB On-Package-Speicher. Niemand vermietet diese Karte mehr, was sie anderswo unerreichbar macht, statt hier nur günstig zu sein — und sie ist weiterhin ein unterstütztes ROCm-Ziel, läuft also mit demselben HIP- und PyTorch-Code wie der MI210, für einen Bruchteil des monatlichen Betrags. Sie ist der vernünftige Weg, eine ROCm-Toolchain zum Laufen zu bringen, bevor man sich auf die große Karte festlegt.

Matrixdurchsatz auf dem MI210

AMD veröffentlicht für den MI210 bei seinem maximalen Boost-Takt von 1.700 MHz eine Spitzenleistung von 181,0 TFLOPS für FP16- und BF16-Matrixoperationen, neben 22,6 TFLOPS Spitzenleistung für FP64- und FP32-Vektoroperationen.

Der Speicher ist die Einschränkung

64 GB fassen die Gewichte eines Modells mit 30 Milliarden Parametern bei 8 Bit oder eines mit 13 Milliarden bei 16 Bit, mit Platz für den KV-Cache. Die Dimensionierung eines Modells ist eine eigene Frage, und die LLM-Seite rechnet diese Arithmetik für jede Genauigkeit durch.

Was der Host der Karte gibt

Die Host-Lane-Generation ist die Tatsache, die fast niemand veröffentlicht, und diejenige, die entscheidet, ob eine Karte mit ihrer vorgesehenen Bandbreite läuft. Wir veröffentlichen unsere neben jeder Karte auf der GPU-Seite.

Nichts zählt die Bytes

Gewichte rein, Checkpoints raus, Datensätze rein. Der Port ist ungedrosselt, sodass ein Trainingslauf, der ein Korpus streamt, am Monatsende nicht als Bandbreitenrechnung ankommt.

Dedizierte Server in HPE-Enterprise-Qualität, angetrieben von AMD Instinct™

HPE Enterprise

Ihr dedizierter Server mit AMD INSTINCT™-GPU wird von HPE-Enterprise-Servern angetrieben und gewährleistet stabile Leistung für die anspruchsvollsten Workloads.

Hardware-Upgrades

Fügen Sie Ihrer Serverinfrastruktur einfach Ressourcen oder weitere Server hinzu. Die meisten Upgrades werden innerhalb von 24 Stunden bearbeitet.

24/7-Support

Dedizierte Server-Experten sind rund um die Uhr per Live-Chat und E-Mail erreichbar.

Der MI210 im Vergleich zu den NVIDIA-Karten, die wir ebenfalls einbauen

Vier Beschleuniger aus demselben Bestellkatalog, also ein Vergleich von Teilen, die Sie tatsächlich in denselben Warenkorb legen können. Hier bewusst keine monatlichen Beträge: Der GPU-Katalog liest sie zum Abfragezeitpunkt aus dem Bestellkatalog, und ein in diese Tabelle getippter Wert kann veralten.

MI210 L40S A100 H100
GPU-Architektur CDNA 2 Ada Lovelace NVIDIA Ampere Hopper
GPU-Speicher 64 GB HBM2e 48 GB GDDR6 mit ECC 80 GB HBM2e 80 GB HBM3
GPU-Speicherbandbreite Bis zu 1,6 TB/s 864 GB/s 1935 GB/s 3352 GB/s
FP32 22,6 TFLOPS 91,6 TFLOPS 19,5 TFLOPS 51 TFLOPS
TF32 Tensor Core 366 TFLOPS 312 TFLOPS 756 TFLOPS
FP16/BF16 Matrix 181 TFLOPS 733 TFLOPS 624 TFLOPS 1513 TFLOPS
Leistungsaufnahme Bis zu 300 W Bis zu 350 W Bis zu 400 W Bis zu 350 W

TF32 ist ein NVIDIA-Tensor-Core-Format. CDNA 2 implementiert es nicht und AMD veröffentlicht dafür keinen Wert, daher zeigt die MI210-Spalte hier nichts anstelle einer von einem anderen Anbieter übernommenen Zahl. Die NVIDIA-Tensor-Core-Zeilen sind die veröffentlichten Werte mit Sparsity. Jede andere Karte, die wir einbauen, einschließlich der MI50, ist im GPU-Katalog bepreist.

FAQ zu AMD-Instinct-GPU-Servern

Häufige Fragen zur Bereitstellung und Verwaltung von AMD-Instinct-Beschleunigern auf Bare-Metal für KI-, HPC- und Machine-Learning-Workloads.

Welche AMD-Instinct-Beschleuniger kann ich tatsächlich bestellen?

Zwei: den Instinct MI210 und den Instinct MI50. Das sind die AMD-Beschleuniger in unserem Bestellkatalog, und der Konfigurator bietet Ihnen nichts anderes aus der Instinct-Reihe an. Der MI210 ist auf drei unserer Serverlinien verfügbar, der MI50 auf zwei. Wir verbauen den MI250, den MI250X oder den MI300A nicht und haben das auch nie getan.

Was ist der Unterschied zwischen dem MI210 und dem MI50?

Generation und Speicher. Der MI210 ist AMDs CDNA-2-Architektur mit 104 Recheneinheiten und 64 GB HBM2e bei bis zu 1,6 TB/s, in einer PCIe-Karte mit zwei Steckplätzen, die bis zu 300 W über eine PCIe-Gen-4-Hostverbindung aufnimmt, mit bis zu drei Infinity-Fabric-Verbindungen für Karte-zu-Karte-Verkehr. Der MI50 ist die frühere GCN-5.1-Generation mit 60 Recheneinheiten und 16 GB. Beide sind unterstützte ROCm-Ziele, sodass derselbe HIP- und PyTorch-Code auf beiden läuft — der MI210 fasst einfach viermal so viel von einem Modell.

Wie viel Kartenspeicher benötigt das Modell, das ich ausführen möchte?

Allein die Gewichte sind Parameter multipliziert mit Bytes pro Parameter: etwa 16 GB für ein Modell mit 7–8 Milliarden Parametern bei 16 Bit, 28 GB für 13–14 Milliarden, 68 GB für 30–34 Milliarden. Der KV-Cache und die Laufzeitumgebung kommen noch hinzu, weshalb eine 16-GB-Karte ein Modell, dessen Gewichte 16 GB groß sind, nicht komfortabel bedient. Die 64 GB des MI210 decken ein auf 8 Bit quantisiertes 30-Milliarden-Modell mit Arbeitsreserve ab. Die LLM-Dimensionierungsseite enthält die gesamte Tabelle — wie viel Speicher jede Modellgröße benötigt und welche Karte das erfüllt.

Wie lange dauert die Bereitstellung eines AMD-Instinct-GPU-Servers?

Wenn die Maschine bereits im Rack steht, wird sie in der Regel etwa 30 Minuten nach Zahlungseingang aktiviert. Wenn nicht, wird sie auftragsbezogen gebaut und die Lieferzeit hängt von den Teilen ab. Fragen Sie vor der Zahlung, wenn der Termin wichtig ist — Sofort-Server ist die Seite für das, was gerade im Rack steht. Jeder Server enthält sofortiges OS-Neuladen, sodass Sie iterieren können, ohne erneut ein Ticket zu öffnen.

Welche Software und Frameworks laufen auf diesen Karten?

ROCm, AMDs Open-Source-GPU-Compute-Plattform. Beide Teile sind unterstützte ROCm-Ziele — gfx90a auf dem MI210, gfx906 auf dem MI50 — und decken damit PyTorch, TensorFlow, JAX und ONNX Runtime ab, zusammen mit den BLAS-, FFT-, RNG- und Deep-Learning-Primitivbibliotheken. HIP portiert vorhandenen CUDA-Quellcode, statt eine Neuimplementierung zu erfordern. Da Sie auf Bare-Metal Root-Rechte haben, wählen Sie die ROCm- und Kernel-Versionen selbst und können das Ganze in Docker oder unter Kubernetes betreiben.