










Acceleratoare AMD Instinct

AMD Instinct pe o mașină pe care nu se află nimeni altcineva

Două acceleratoare AMD intră în serverele noastre dedicate: Instinct MI210 și Instinct MI50. Placa este pasată direct către propriul tău sistem de operare — build-ul tău ROCm, kernelul tău, procesele tale și niciun hypervisor între ele.

MI210: 104 unități de calcul CDNA 2, 64 GB HBM2e. MI50: 60 de unități de calcul GCN 5.1, 16 GB. Un singur chiriaș pe mașină. Fără partajare, fără time-sharing.

Fiecare placă pe care o montăm — AMD și NVIDIA, actuale sau ieșite de mult din producție — este listată cu prețul ei lunar pe catalogul GPU.

Transformă-ți GPU-urile în venit lunar pasiv

Ai configurații GPU idle pe servere sau desktopuri? Listează-le astăzi pe piața Primcast și câștigă chirii lunare constante de la echipe AI, dezvoltatori și întreprinderi care au nevoie de putere de calcul de nivel de producție.

Mergi la Marketplace

Ce este de fapt un server AMD Instinct aici

Un server fizic închiriat unui singur cont, cu un accelerator AMD într-un slot PCIe și acces root la sistemul de operare de deasupra lui. Placa este o linie pe factură, nu un nivel de produs, așa că mașina de dedesubt nu devine mai scumpă din cauza a ceea ce este conectat la ea.

Placa este a ta

Fără partiții, fără vGPU, fără un planificator care să decidă când îți vine rândul. Acceleratorul este predat direct kernelului tău, așa că îți fixezi propria versiune ROCm și îți încarci propriile module fără să ne întrebi.

ROCm, HIP și framework-urile obișnuite

Ambele componente sunt ținte ROCm acceptate — gfx90a pentru MI210, gfx906 pentru MI50 — ceea ce reprezintă baza pe care PyTorch, TensorFlow, JAX și ONNX Runtime se construiesc pe AMD. HIP portează codul sursă CUDA, în loc să necesite o rescriere.

Preț separat de mașină

Acceleratorul are propria sumă lunară, iar serverul are alta, iar tu le aduni pe cele două. Schimbă placa fără să schimbi serverul. Ambele sume, pentru fiecare placă din catalog, sunt pe pagina GPU.

Cele două acceleratoare AMD Instinct pe care le montăm

Ambele pot fi comandate astăzi din același configurator, pe linii de server diferite. Cifrele de mai jos sunt cele publicate de AMD.
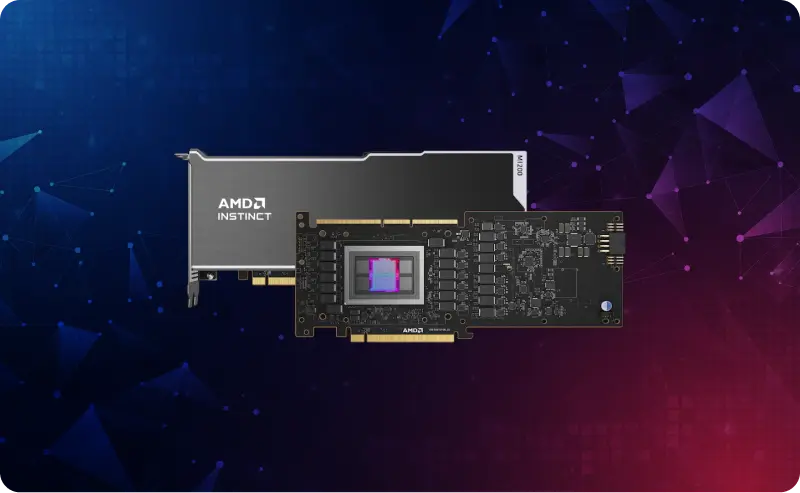
Accelerator AMD Instinct MI210

AMD Instinct MI210

Generația CDNA 2 într-o placă PCIe standard full-height, full-length, dual-slot — 104 unități de calcul, 64 GB de HBM2e la până la 1,6 TB/s și până la trei legături Infinity Fabric pentru trafic direct placă-la-placă. Răcită pasiv la 300 W printr-o legătură gazdă PCIe Gen 4. Aceasta este cea pe care o ceri atunci când întreaga întrebare este dacă modelul încape în memorie.

AMD Instinct MI50

Componenta mai veche din generația Vega: siliciu GCN 5.1, 60 de unități de calcul și 16 GB de memorie pe pachet. Nimeni nu mai închiriază această placă, ceea ce o face de negăsit în altă parte, nu doar ieftină aici — și este încă o țintă ROCm acceptată, așa că rulează același cod HIP și PyTorch ca MI210 pentru o fracțiune din suma lunară. Este modalitatea rațională de a pune în funcțiune un lanț de instrumente ROCm înainte de a te angaja la placa mare.

Debit matriceal pe MI210

AMD publică 181,0 TFLOPS de performanță matriceală de vârf FP16 și BF16 pentru MI210 la ceasul său de boost maxim de 1.700 MHz, alături de 22,6 TFLOPS de vârf FP64 și FP32 vectorial.

Memoria este constrângerea

64 GB țin greutățile unui model de 30 de miliarde de parametri la 8 biți, sau ale unuia de 13 miliarde la 16 biți, cu spațiu rămas pentru cache-ul KV. Dimensionarea unui model este o întrebare în sine, iar pagina LLM parcurge această aritmetică la fiecare precizie.

Ce oferă gazda plăcii

Generația de lane a gazdei este faptul pe care aproape nimeni nu îl publică și cel care decide dacă o placă rulează la lățimea de bandă proiectată. Noi o publicăm pe a noastră lângă fiecare placă, pe pagina GPU.

Nimeni nu numără octeții

Greutăți înăuntru, checkpoint-uri afară, seturi de date înăuntru. Portul este nemăsurat, așa că o rulare de antrenament care transmite un corpus nu ajunge ca factură de lățime de bandă la sfârșitul lunii.

Servere dedicate de nivel enterprise HPE alimentate de AMD Instinct™

HPE enterprise

Serverul tău dedicat GPU AMD INSTINCT™ este alimentat de servere HPE Enterprise, asigurând performanță stabilă pentru cele mai solicitante sarcini de lucru.

Upgrade-uri hardware

Adaugă cu ușurință resurse sau servere suplimentare la infrastructura ta de servere. Majoritatea upgrade-urilor sunt procesate în 24 de ore.

Suport 24/7

Experți în servere dedicate sunt disponibili pentru asistență 24/7 prin chat live și e-mail.

MI210 față de plăcile NVIDIA pe care le montăm și noi

Patru acceleratoare din același catalog de comenzi, deci aceasta compară componente pe care le poți pune efectiv în același coș. Fără sume lunare aici, intenționat: catalogul GPU le citește din catalogul de comenzi la momentul cererii, iar o cifră tastată în acest tabel poate devia.

MI210 L40S A100 H100
Arhitectură GPU CDNA 2 Ada Lovelace NVIDIA Ampere Hopper
Memorie GPU 64GB HBM2e 48GB GDDR6 cu ECC 80GB HBM2e 80GB HBM3
Lățime de bandă memorie GPU Până la 1,6 TB/s 864 GB/s 1935 GB/s 3352 GB/s
FP32 22,6 TFLOPS 91,6 TFLOPS 19,5 TFLOPS 51 TFLOPS
TF32 Tensor Core 366 TFLOPS 312 TFLOPS 756 TFLOPS
Matrice FP16/BF16 181 TFLOPS 733 TFLOPS 624 TFLOPS 1513 TFLOPS
Putere Până la 300W Până la 350W Până la 400W Până la 350W

TF32 este un format tensor-core NVIDIA. CDNA 2 nu îl implementează, iar AMD nu publică nicio cifră pentru el, așa că coloana MI210 nu arată nimic acolo, în loc de un număr împrumutat de la alt furnizor. Rândurile tensor-core NVIDIA sunt cifrele publicate cu sparsity. Fiecare altă placă pe care o montăm, inclusiv MI50, are prețul pe catalogul GPU.

Întrebări frecvente despre serverele GPU AMD Instinct

Întrebări frecvente despre implementarea și gestionarea acceleratoarelor AMD Instinct pe bare metal pentru sarcini de lucru AI, HPC și machine learning.

Ce acceleratoare AMD Instinct pot comanda efectiv?

Două: Instinct MI210 și Instinct MI50. Acestea sunt acceleratoarele AMD din catalogul nostru de comenzi, iar configuratorul nu îți va oferi nimic altceva din linia Instinct. MI210 se montează pe trei dintre liniile noastre de servere, iar MI50 pe două. Nu montăm MI250, MI250X sau MI300A și nu am făcut-o niciodată.

Care este diferența dintre MI210 și MI50?

Generația și memoria. MI210 este arhitectura CDNA 2 de la AMD, cu 104 unități de calcul și 64 GB de HBM2e la până la 1,6 TB/s, într-o placă PCIe dual-slot care consumă până la 300 W printr-o legătură gazdă PCIe Gen 4, cu până la trei legături Infinity Fabric pentru trafic placă-la-placă. MI50 este generația anterioară GCN 5.1, cu 60 de unități de calcul și 16 GB. Ambele sunt ținte ROCm acceptate, așa că același cod HIP și PyTorch rulează pe oricare dintre ele — MI210 pur și simplu ține de patru ori mai mult dintr-un model.

Câtă memorie de placă are nevoie modelul pe care vreau să-l rulez?

Doar greutățile sunt parametri înmulțiți cu octeți per parametru: aproximativ 16 GB pentru un model de 7-8 miliarde de parametri la 16 biți, 28 GB pentru 13-14 miliarde, 68 GB pentru 30-34 de miliarde. Cache-ul KV și runtime-ul se adaugă peste asta, motiv pentru care o placă de 16 GB nu servește confortabil un model ale cărui greutăți sunt de 16 GB. Cei 64 GB ai MI210 acoperă un model de 30 de miliarde cuantizat la 8 biți, cu spațiu de lucru. Pagina de dimensionare LLM are întregul tabel — câtă memorie are nevoie fiecare dimensiune de model și ce placă o acoperă.

Cât durează implementarea unui server GPU AMD Instinct?

Acolo unde mașina este deja în rack, este de obicei activată la aproximativ 30 de minute după confirmarea plății. Acolo unde nu este, este construită la comandă, iar timpul de livrare depinde de componente. Întreabă înainte să plătești dacă data contează — serverele instant este pagina pentru ceea ce se află chiar acum într-un rack. Fiecare server include reîncărcare instant a sistemului de operare, astfel încât să poți itera fără să redeschizi un tichet.

Ce software și framework-uri rulează pe aceste plăci?

ROCm, platforma open-source de calcul GPU de la AMD. Ambele componente sunt ținte ROCm acceptate — gfx90a pe MI210, gfx906 pe MI50 — ceea ce acoperă PyTorch, TensorFlow, JAX și ONNX Runtime, împreună cu bibliotecile primitive BLAS, FFT, RNG și deep-learning. HIP portează codul sursă CUDA existent, în loc să necesite o rescriere. Pentru că ai acces root pe bare metal, alegi singur versiunile ROCm și kernel și poți rula totul în Docker sau sub Kubernetes.